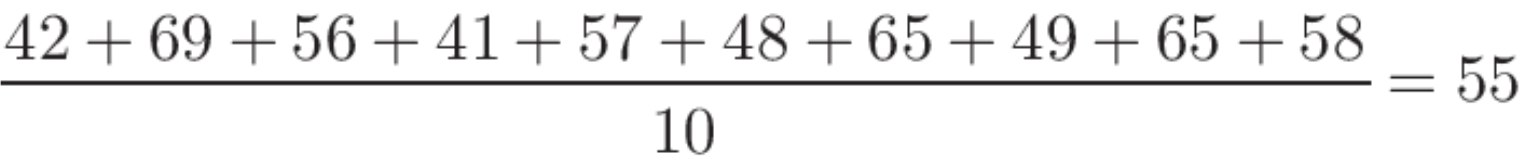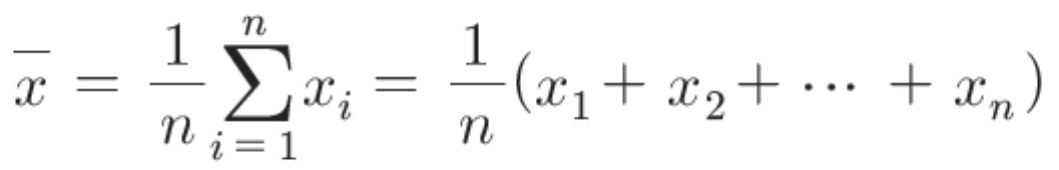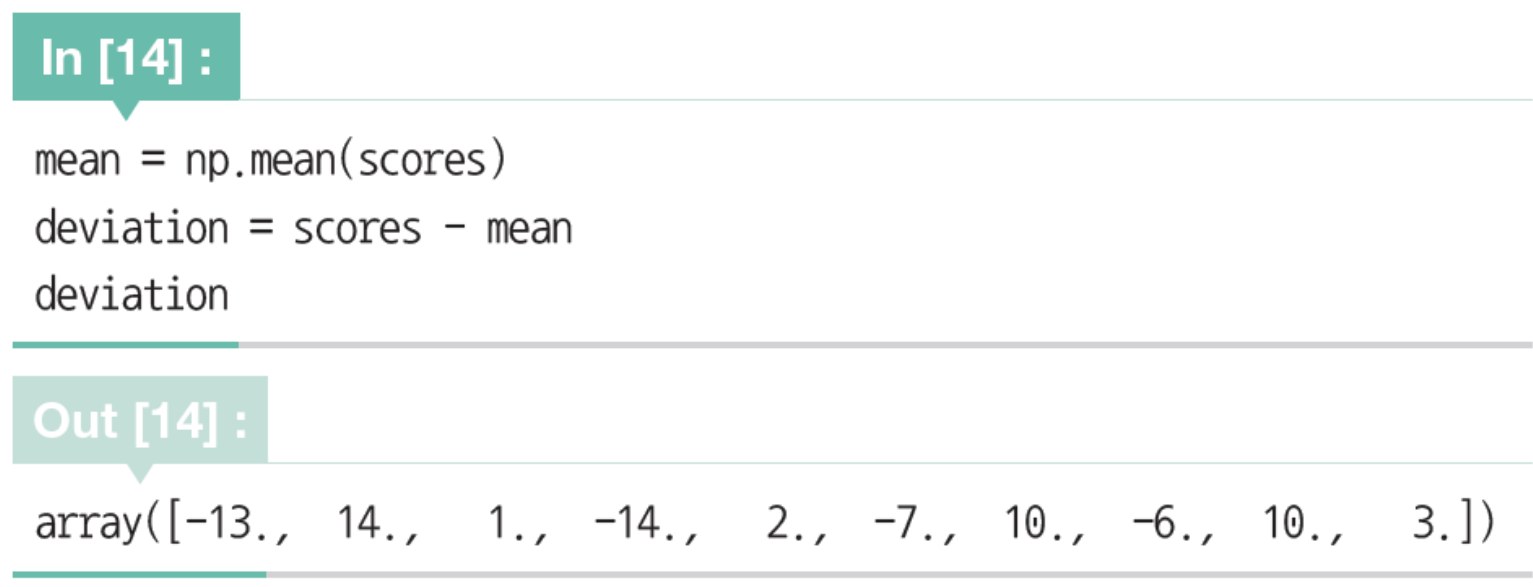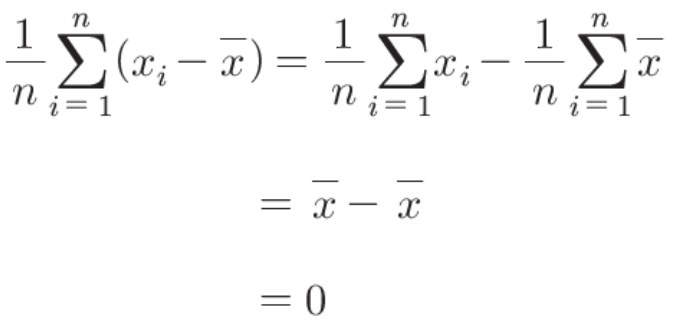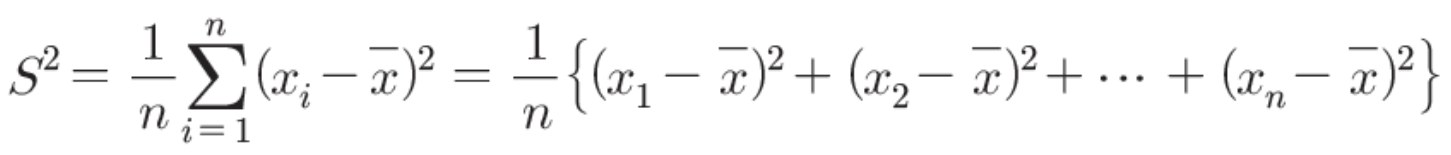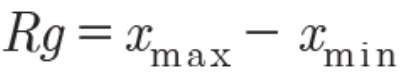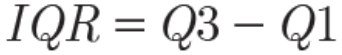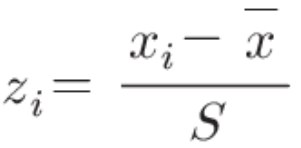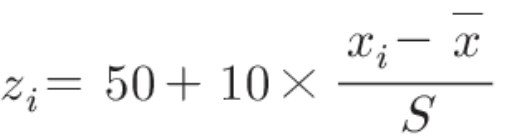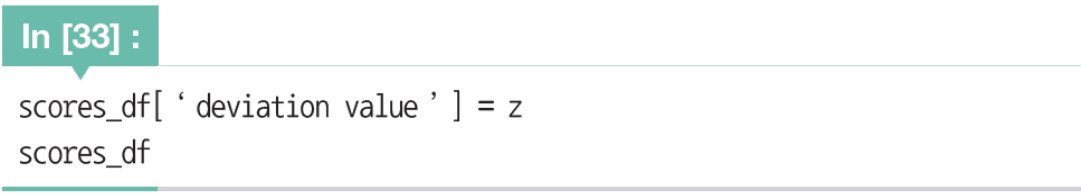


02주차 · 1차원 데이터 정리 — 지표 계산·시각화01

02주차 · 1차원 데이터 정리 — 지표 계산·시각화02
열마다 어떤 종류의 변수인지에 따라 쓸 수 있는 지표가 갈린다.
| 구분 | 무엇인가 | 예 |
|---|---|---|
| 질적 변수 | 선택이 필요한 변수, 종류를 구별하기 위한 변수 | 설문 응답(1 매우 좋음 · 2 좋음 · 3 보통 · 4 나쁨 · 5 매우 나쁨), 혈액형(A형 · B형 · O형 · AB형) |
| 양적 변수 | 양을 표현하는 변수 | 다음 장에서 이산형과 연속형으로 다시 나뉜다 |
2장에서 다루는 평균·분산·표준편차는 모두 양적 변수에 쓴다. 질적 변수에 쓸 수 있는 것은 최빈값 쪽이다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화03
[표 1-1] 척도 수준 — 대소 관계·차이·비 가운데 무엇을 따질 수 있느냐로 나뉜다.
| 척도 | 예 | 대소 관계 | 차이 | 비 |
|---|---|---|---|---|
| 명의 척도 | 학생번호 | × | × | × |
| 순서 척도 | 성적 순위 | ○ | × | × |
| 간격 척도 | 온도 | ○ | ○ | × |
| 비례 척도 | 키 | ○ | ○ | ○ |
02주차 · 1차원 데이터 정리 — 지표 계산·시각화04
양적 변수는 값이 띄엄띄엄한지 이어지는지로 다시 갈린다.
| 구분 | 값의 성질 | 예 |
|---|---|---|
| 이산형 변수 | 하나하나의 값을 취한다. 서로 인접한 숫자 사이에 값이 존재하지 않는다 | 주사위의 눈, 결석 횟수, 결석 학생 수 |
| 연속형 변수 | 연속적인 값을 취한다. 어떤 두 숫자 사이에도 반드시 숫자가 존재한다 | 길이, 무게, 시간 |
02주차 · 1차원 데이터 정리 — 지표 계산·시각화05

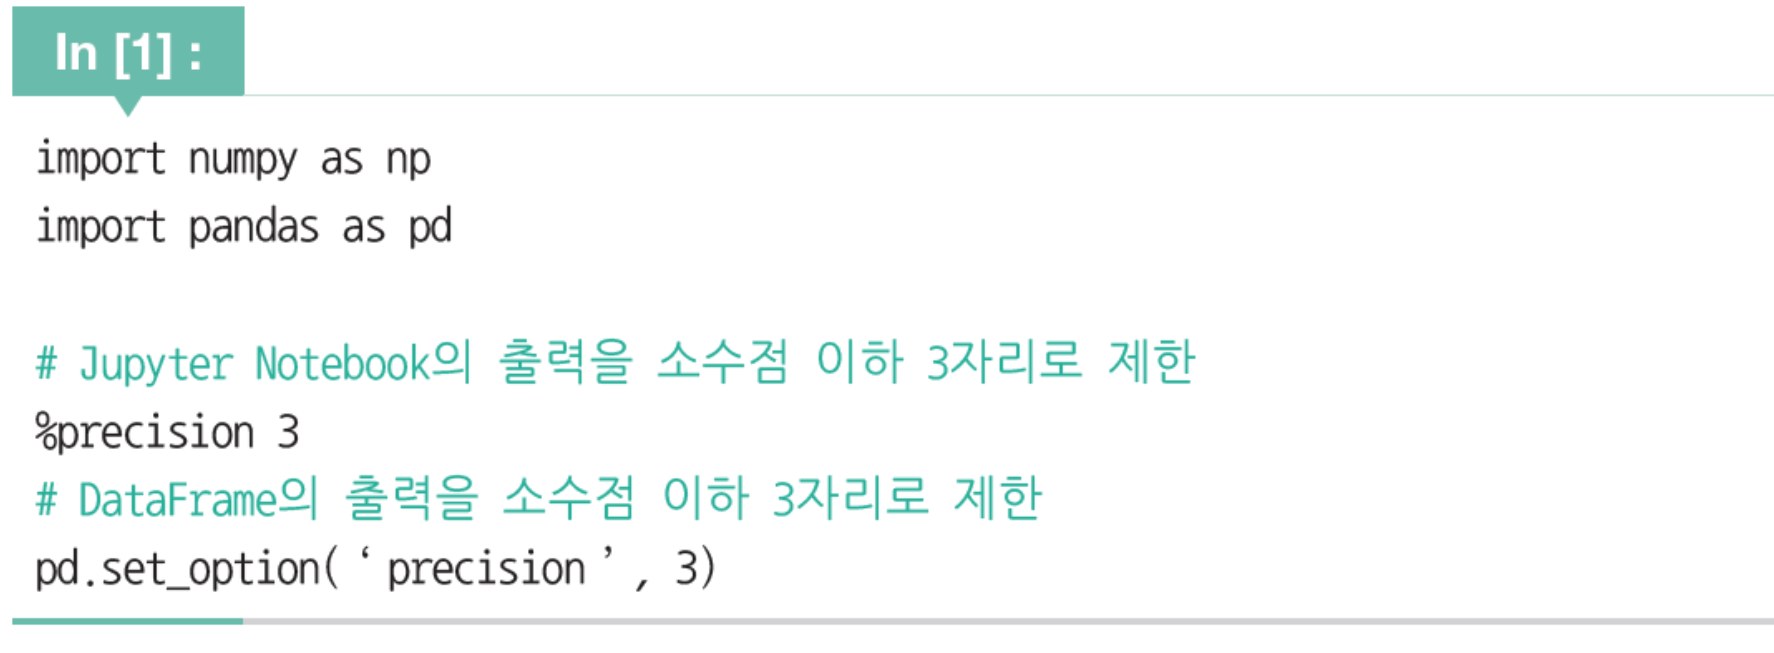
수치계산과 통계분석에 필요한 라이브러리 임포트하고,
출력을 소수점 이하 3자리로 설정
02주차 · 1차원 데이터 정리 — 지표 계산·시각화06

02주차 · 1차원 데이터 정리 — 지표 계산·시각화07

02주차 · 1차원 데이터 정리 — 지표 계산·시각화08

02주차 · 1차원 데이터 정리 — 지표 계산·시각화09
2.1 데이터 중심의 지표


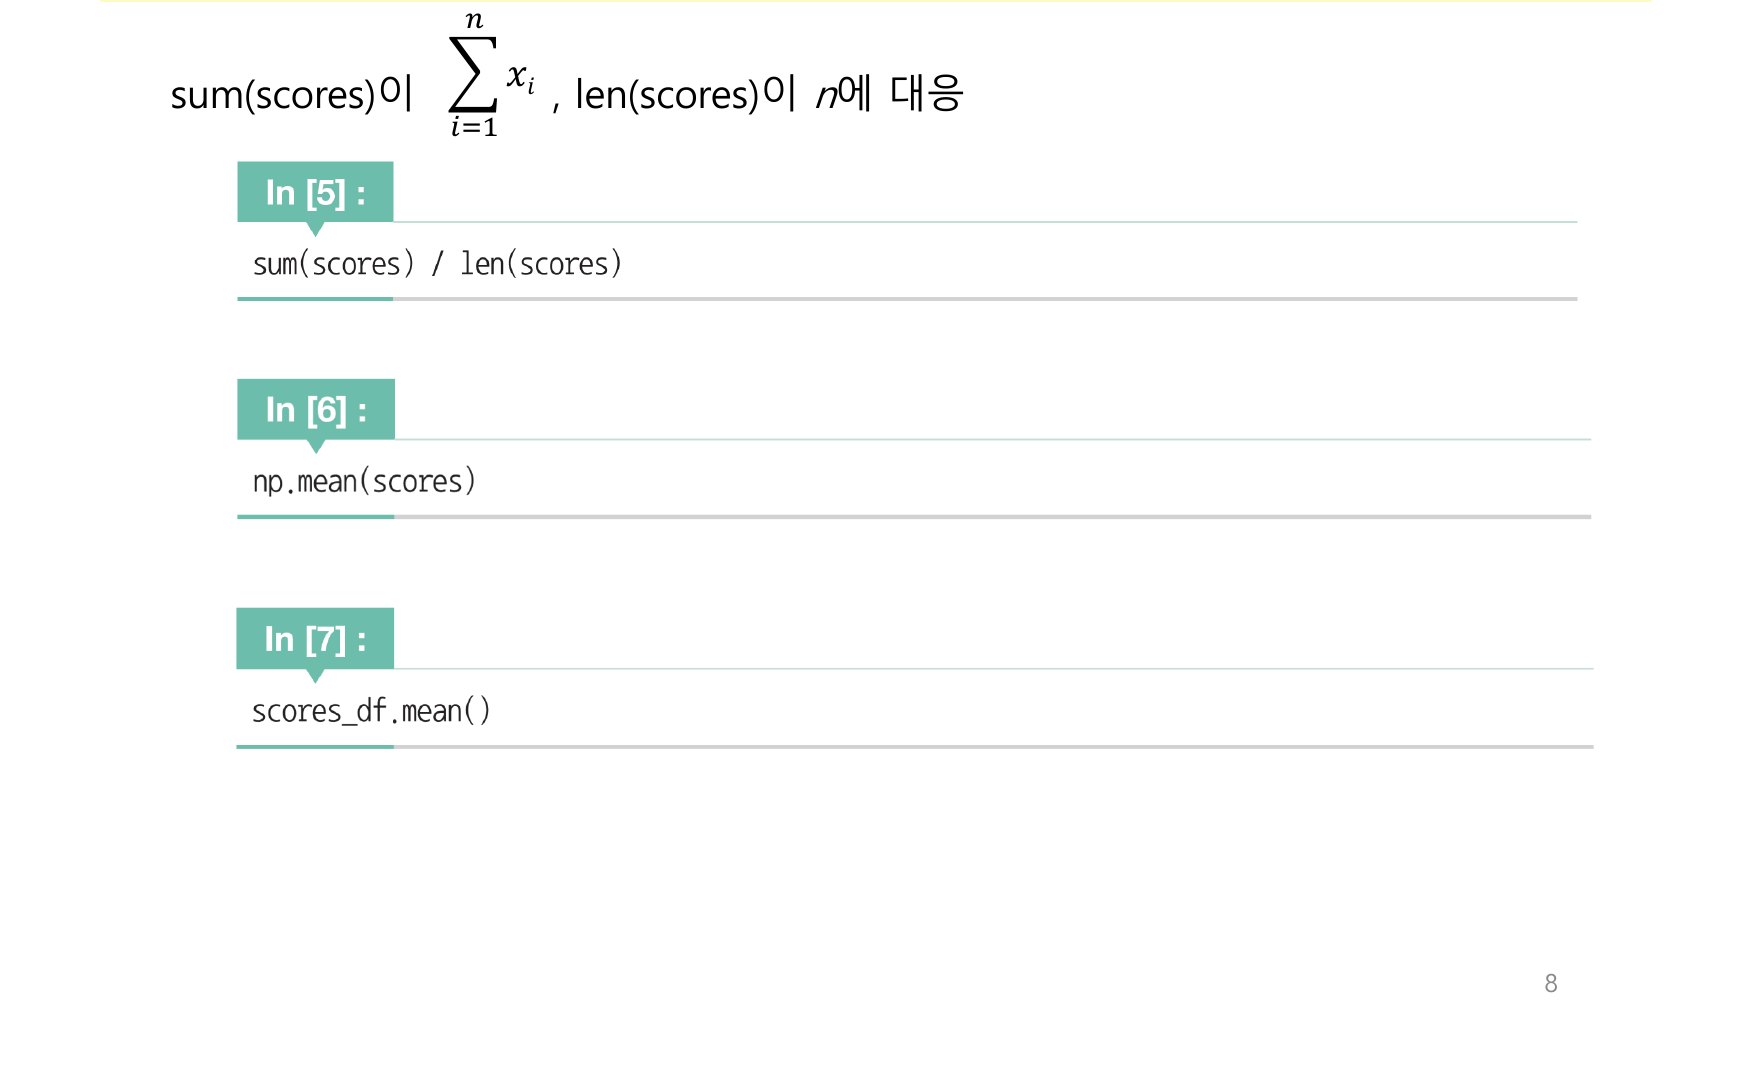
평균값은 데이터를 모두 더한 뒤, 데이터의 개수로 나누어 구함
02주차 · 1차원 데이터 정리 — 지표 계산·시각화10
2.1 데이터 중심의 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화11
2.1 데이터 중심의 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화12
2.1 데이터 중심의 지표


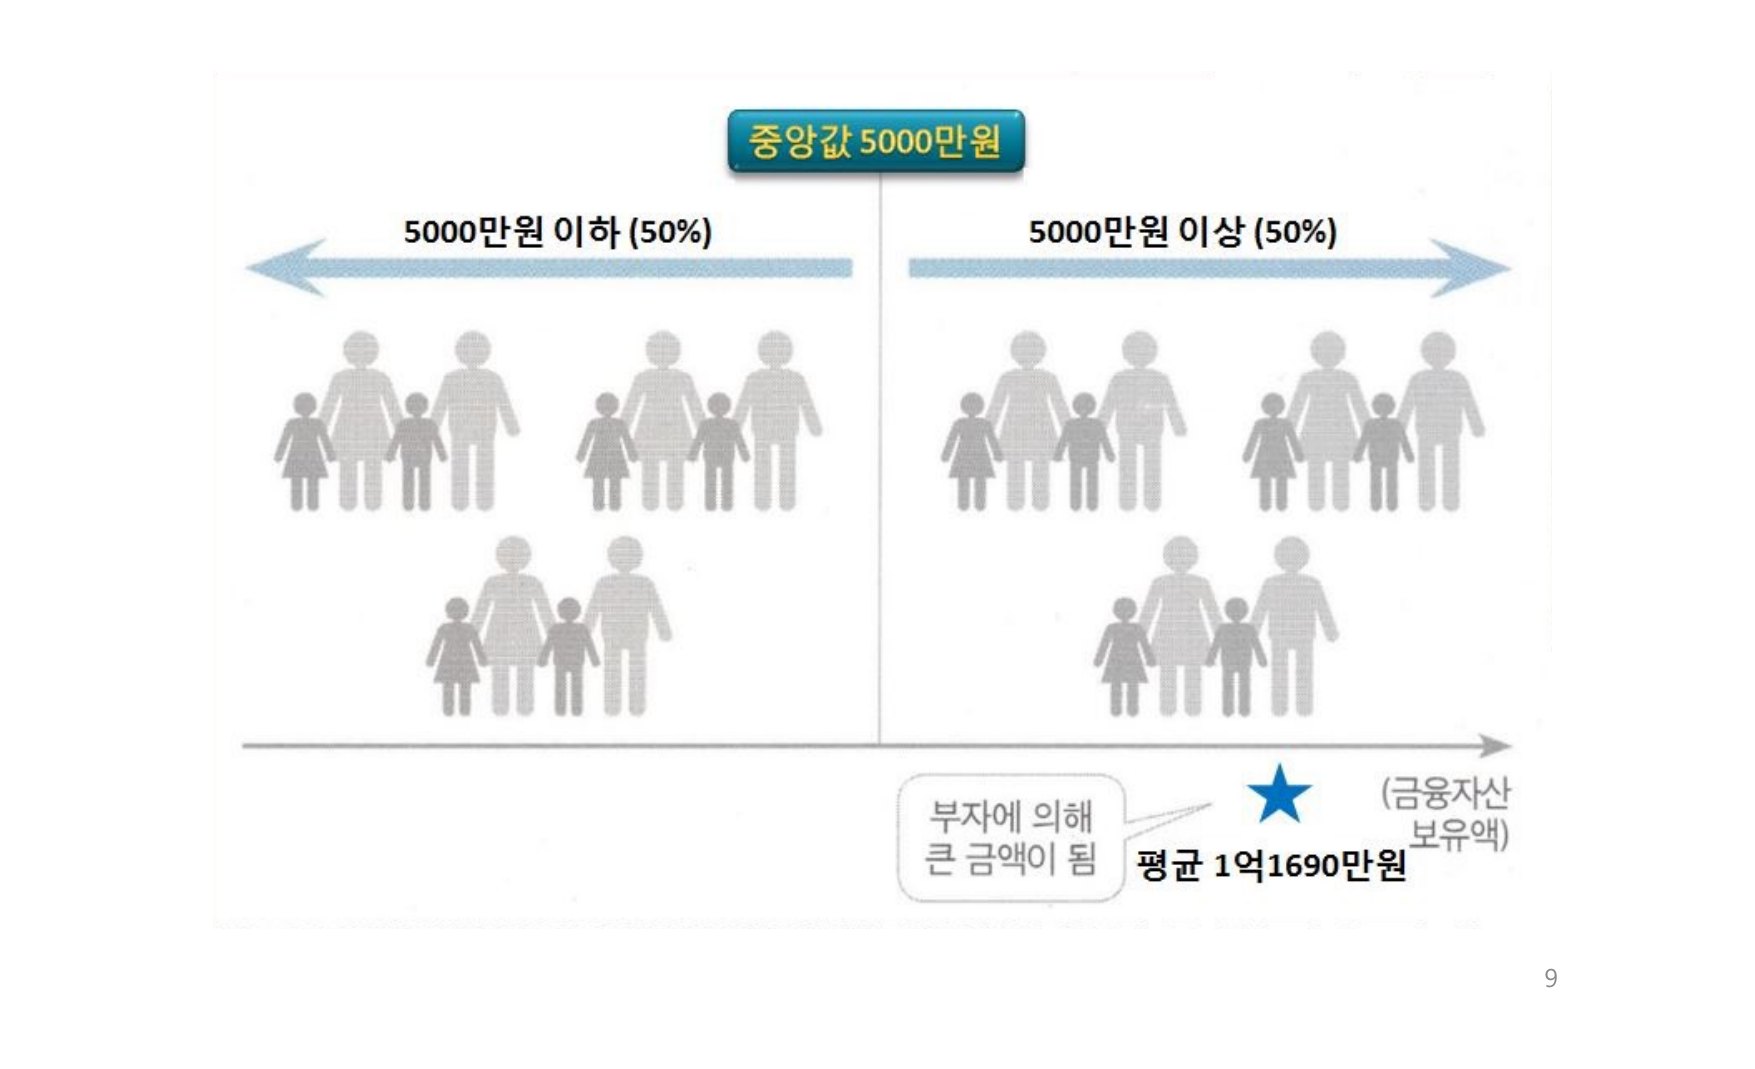
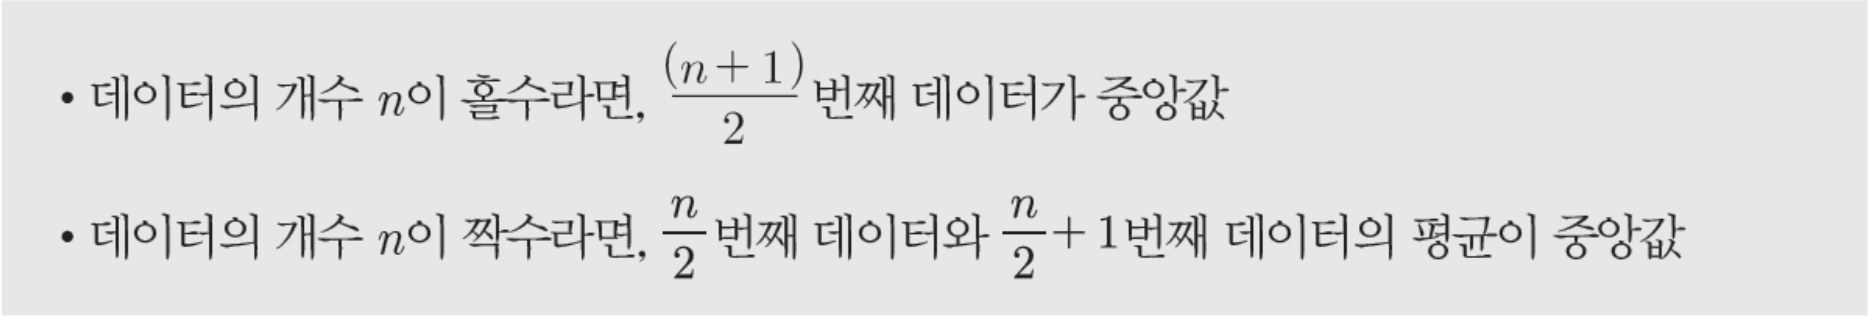
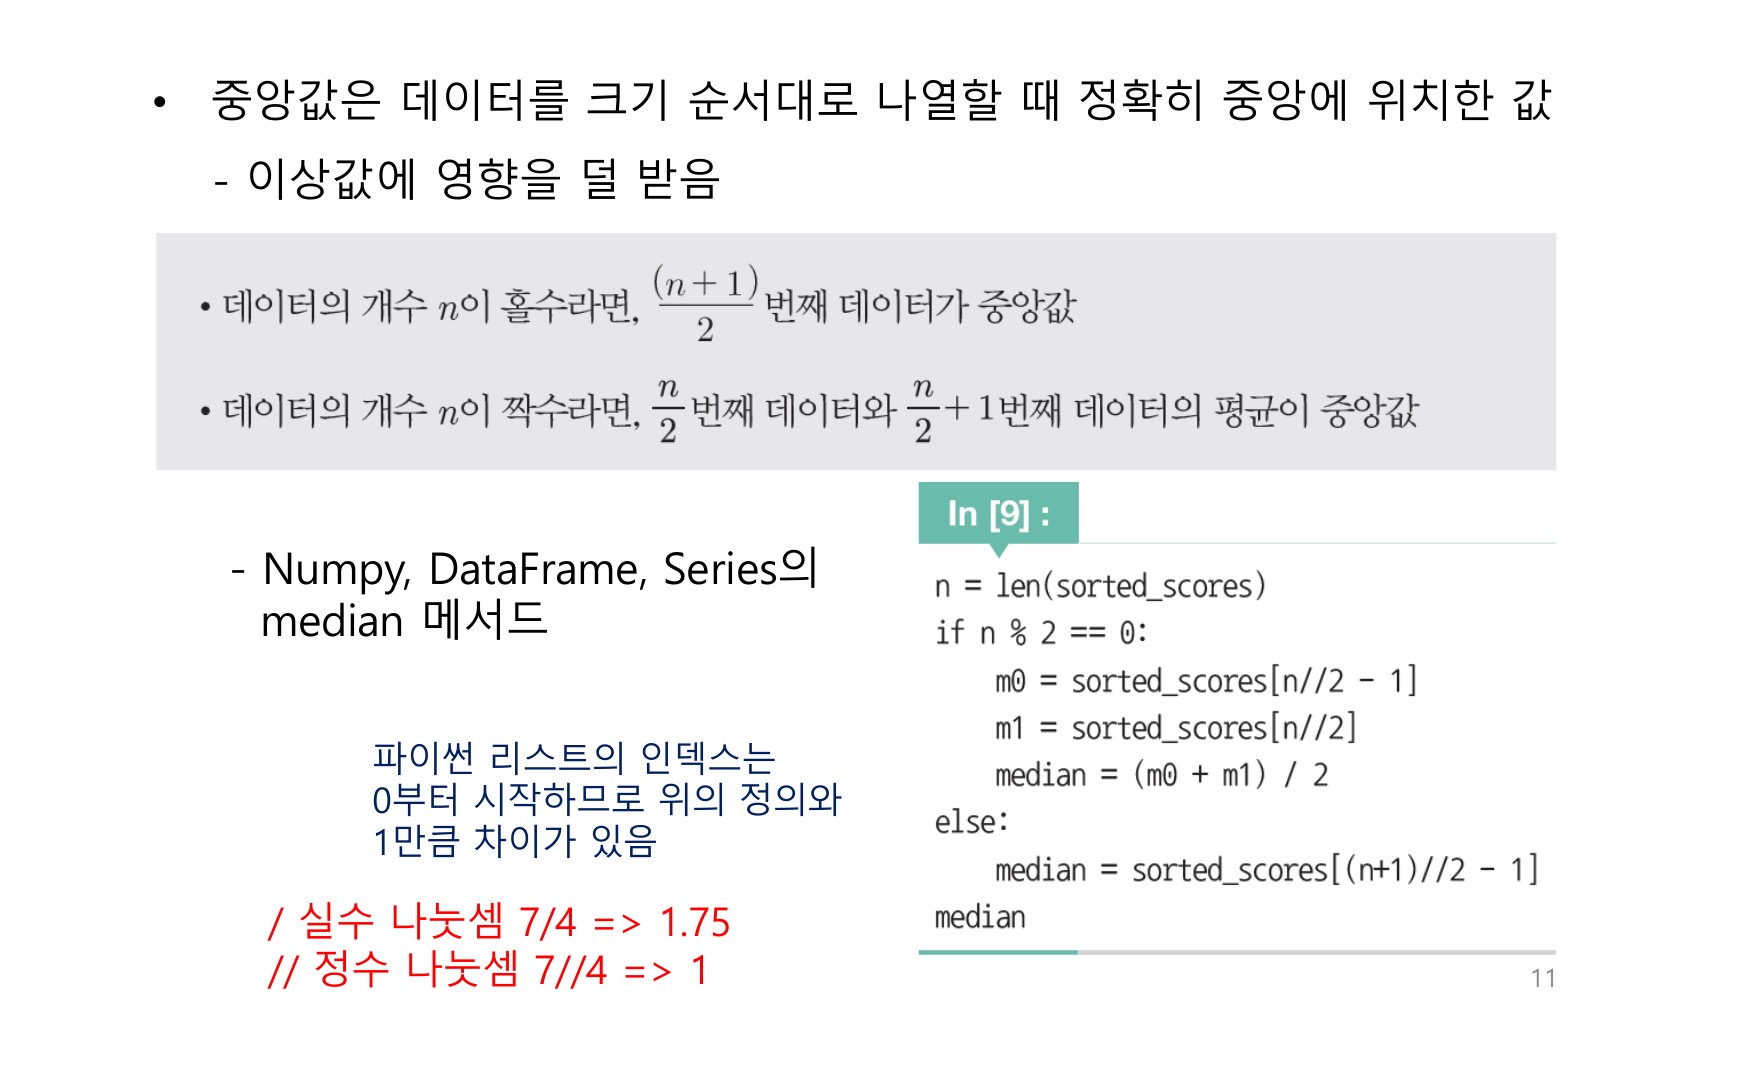
중앙값은 데이터를 크기 순서대로 나열할 때 정확히 중앙에 위치한 값
- 이상값에 영향을 덜 받음
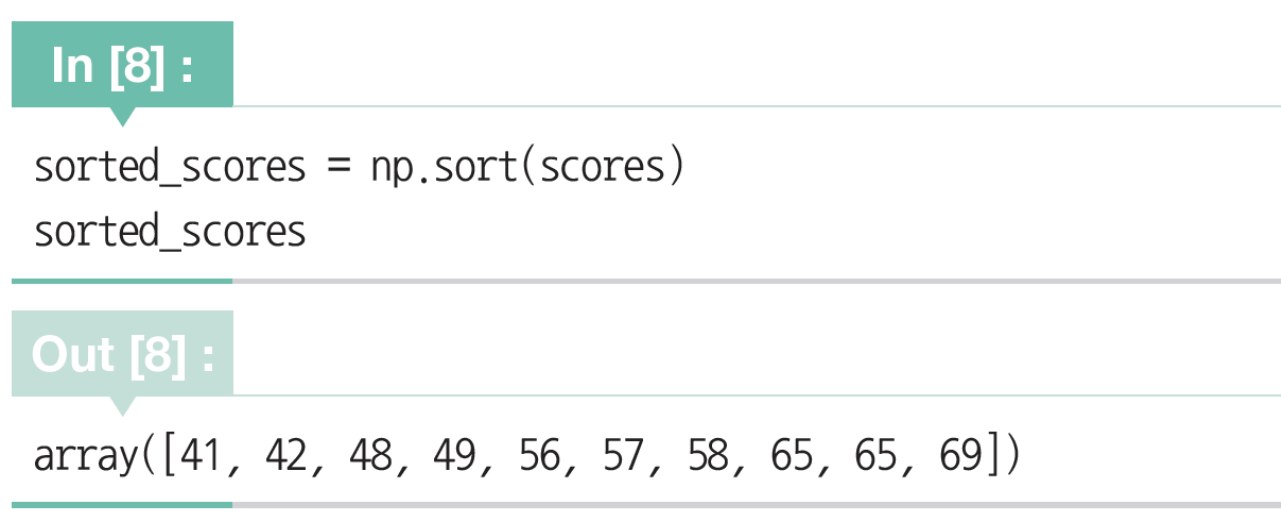
정렬 후 코드 작성 및 실행
56 + 57
= 56.5
2
02주차 · 1차원 데이터 정리 — 지표 계산·시각화13
2.1 데이터 중심의 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화14
양쪽 끝을 조금씩 잘라내고 남은 값들의 평균


두 종목 모두 심판 점수의 최고·최저를 잘라내고 나머지를 평균낸다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화15
2.1 데이터 중심의 지표
10% 절사평균
예> 20개의 자료 중 양쪽에서 하나씩 모두 2개를 제거한 뒤 18개의 평균
20% 절사평균
예> 20개의 자료 중 양쪽에서 두개씩 모두 4개를 제거한 뒤 16개의 평균
다이빙 점수
7명의 심판 중 최고점과 최저점을 제외하고 5명의 평균에 난이도를 고려
해서 계산
02주차 · 1차원 데이터 정리 — 지표 계산·시각화16
2.1 데이터 중심의 지표

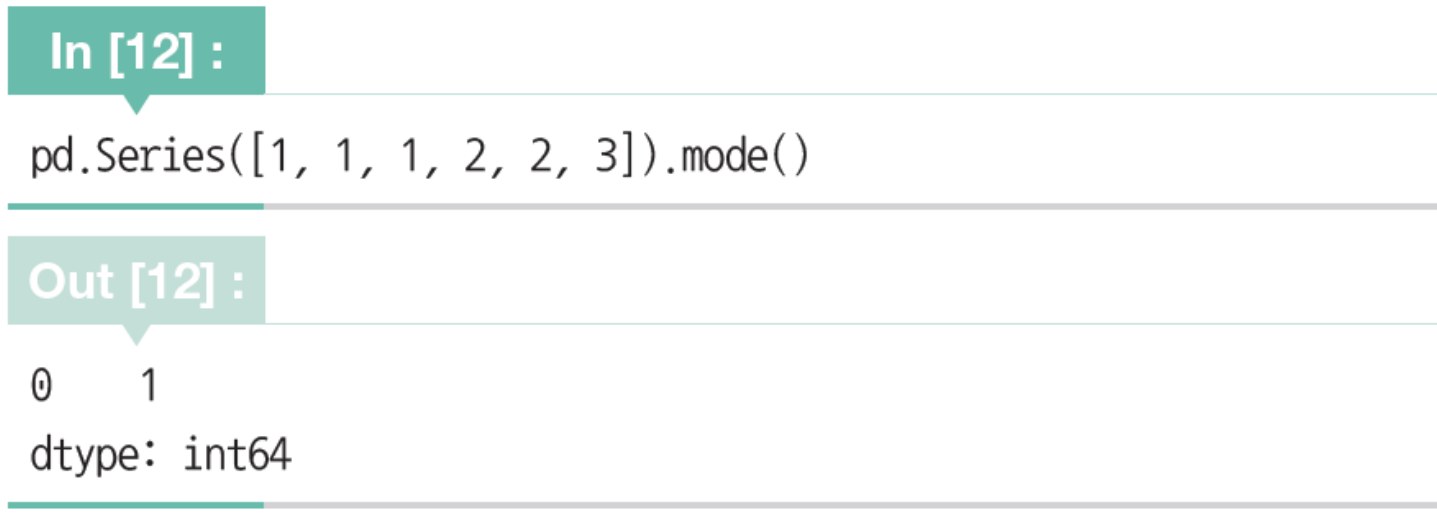
최빈값은 데이터에서 가장 많이 나타나는 값
- [1, 1, 1, 2, 2, 3]에서 최빈값은 1
- DataFrame, Series의 mode 메서드
02주차 · 1차원 데이터 정리 — 지표 계산·시각화17
2.2 데이터의 산포도 지표

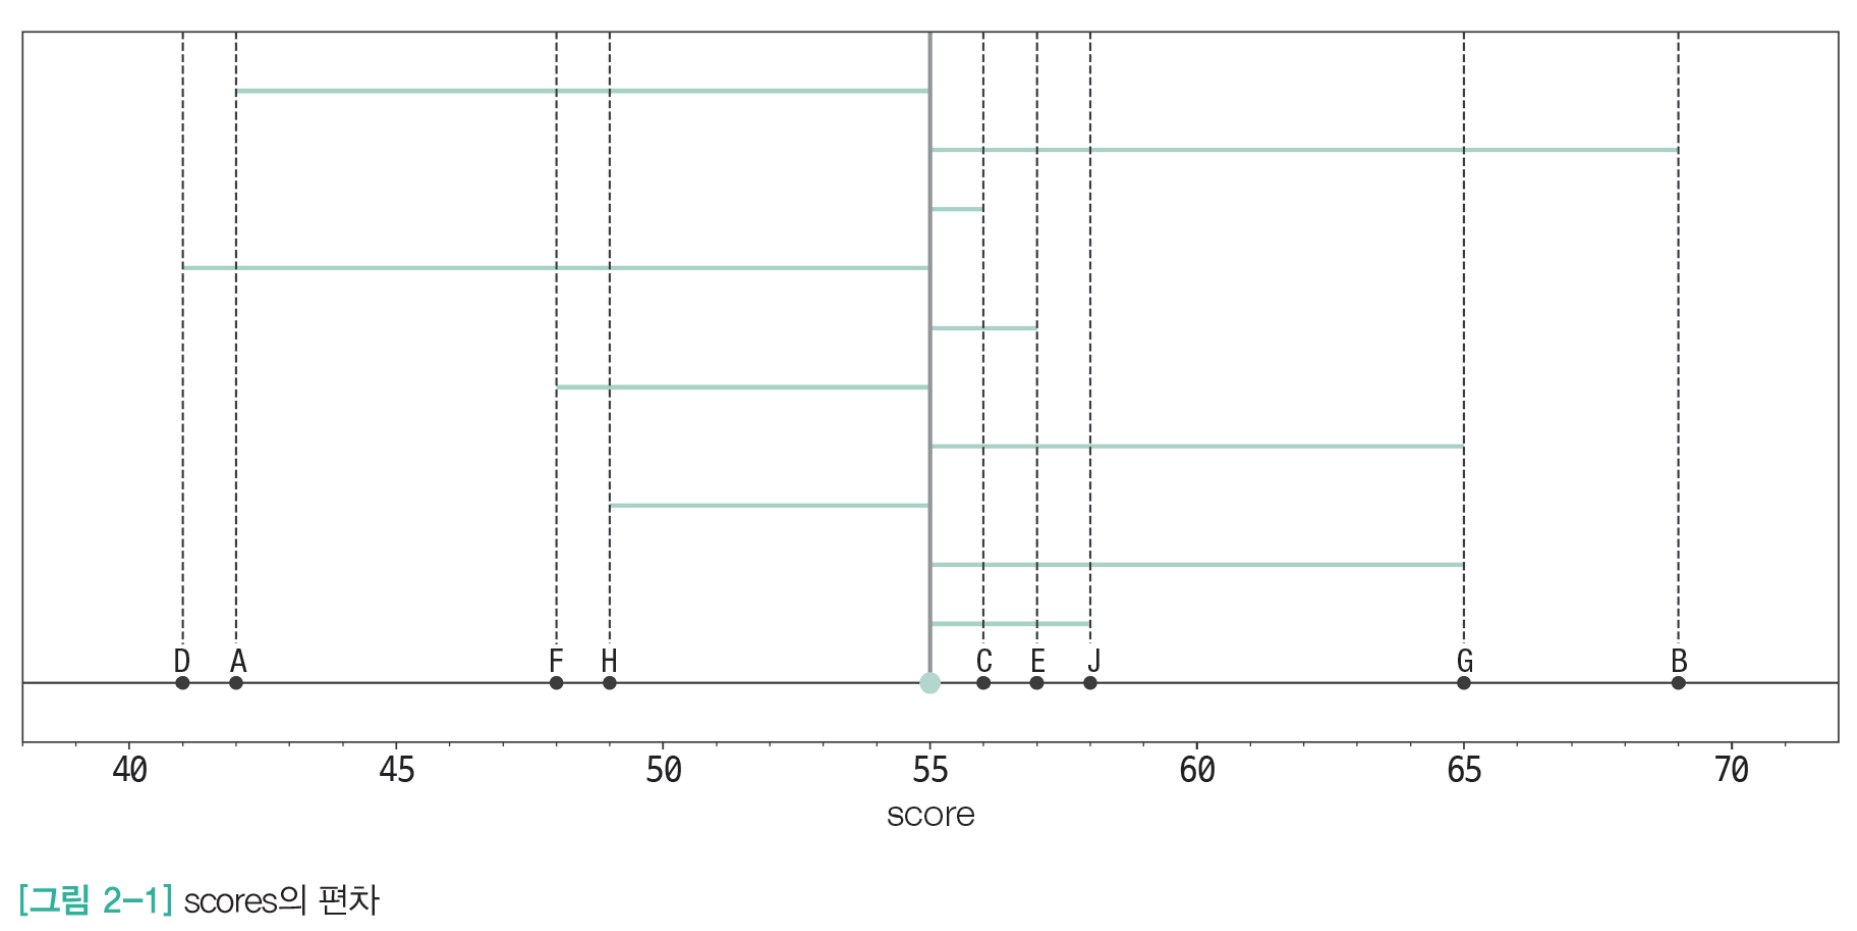
편차
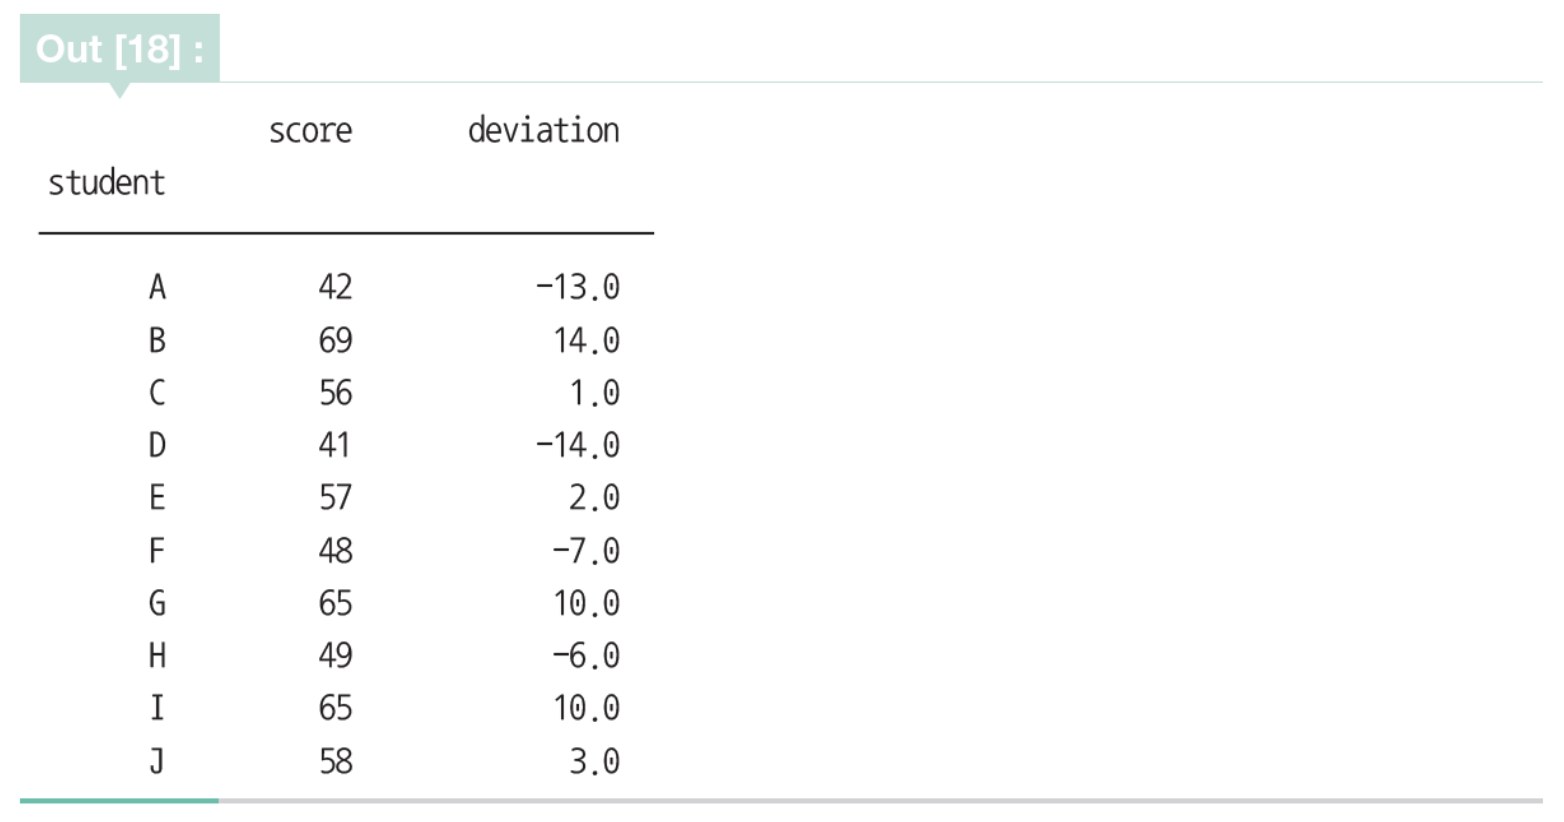
각 데이터가 평균으로부터 떨어져 있는 정도
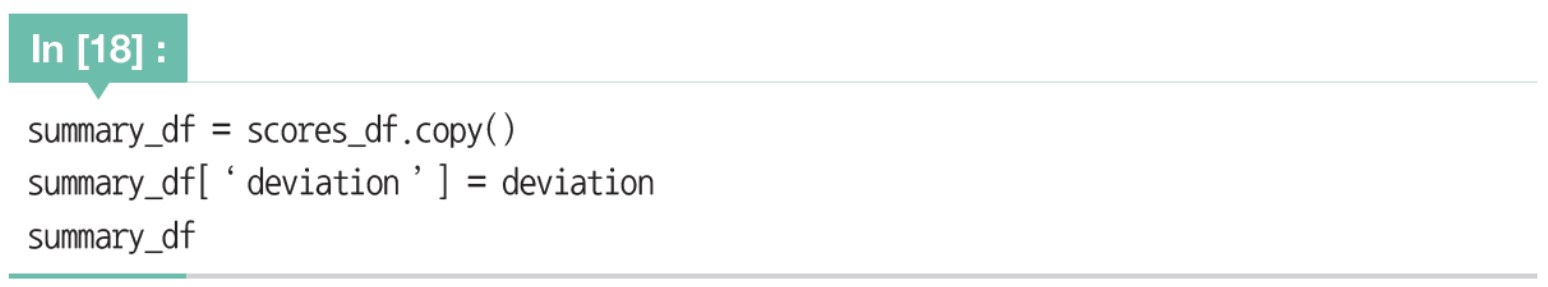
각 학생의 성적 편차
02주차 · 1차원 데이터 정리 — 지표 계산·시각화18
2.2 데이터의 산포도 지표

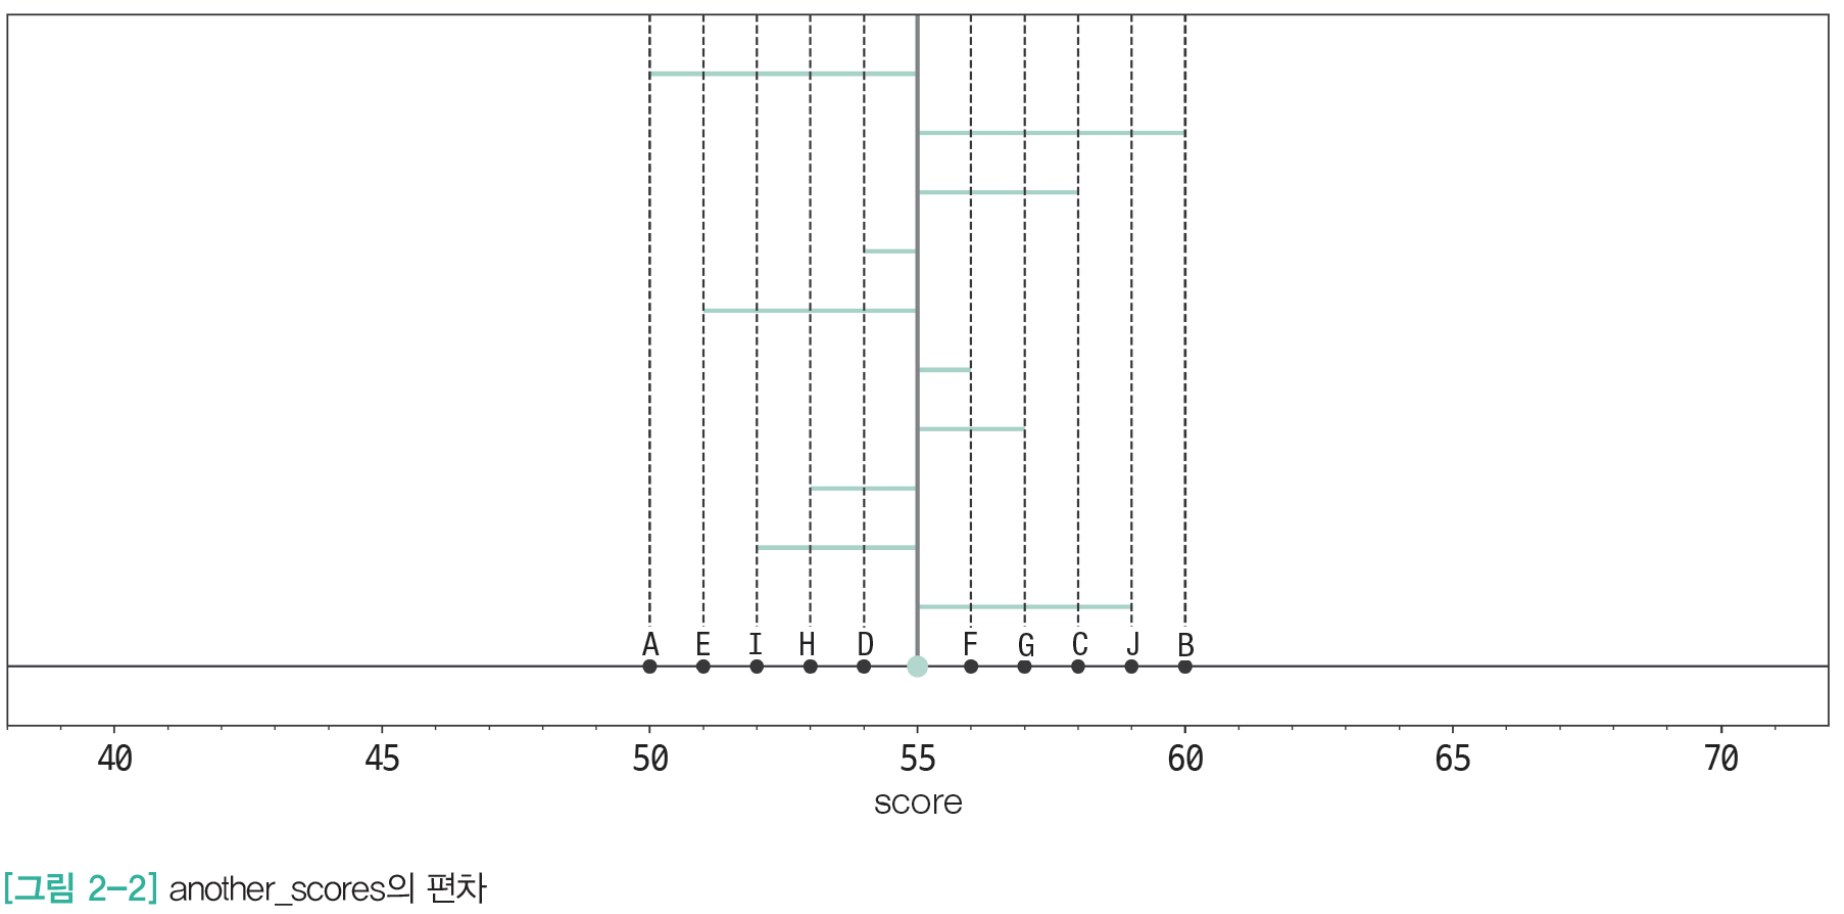
편차 비교
- Scores의 편차가 더 큼
02주차 · 1차원 데이터 정리 — 지표 계산·시각화19
2.2 데이터의 산포도 지표

편차 비교
- Scores의 편차가 더 큼
02주차 · 1차원 데이터 정리 — 지표 계산·시각화20
2.2 데이터의 산포도 지표

편차 비교
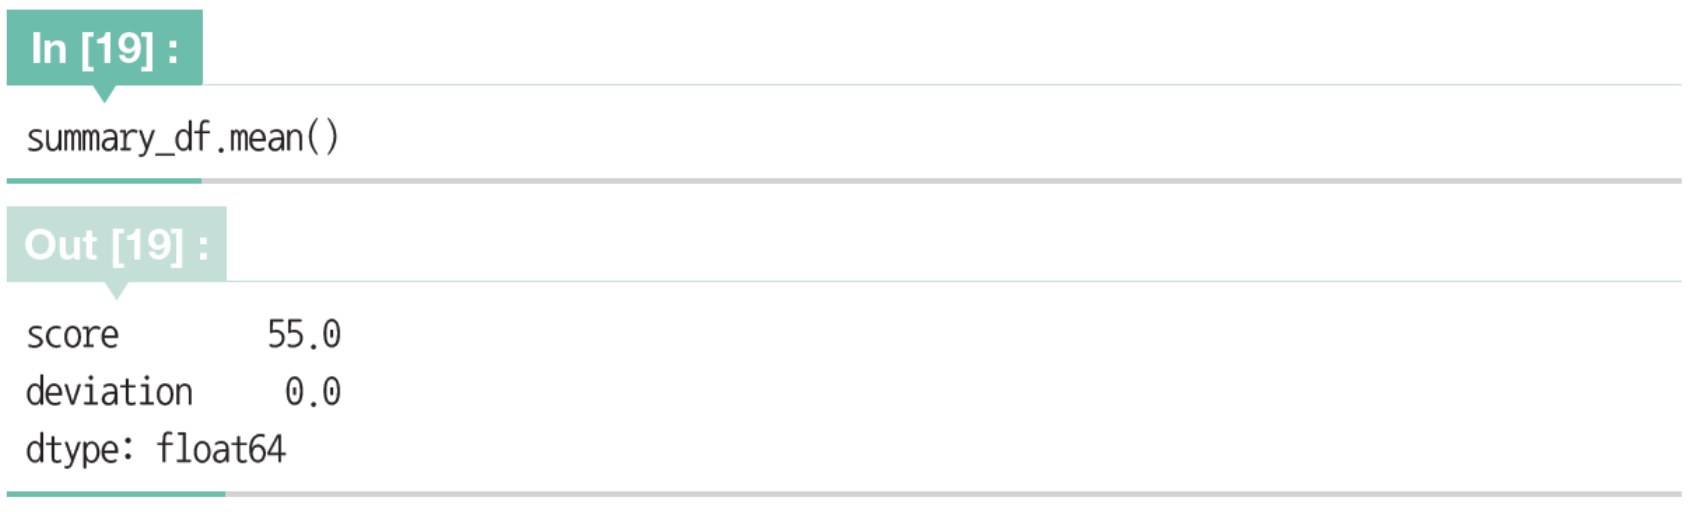
- 10명의 편찻값으로 비교가 어려우므로, 하나의 값인 편차 평균 비교
- 편차 평균은 0
02주차 · 1차원 데이터 정리 — 지표 계산·시각화21
2.2 데이터의 산포도 지표


편차 비교
02주차 · 1차원 데이터 정리 — 지표 계산·시각화22
2.2 데이터의 산포도 지표

편차 비교
02주차 · 1차원 데이터 정리 — 지표 계산·시각화23
2.2 데이터의 산포도 지표


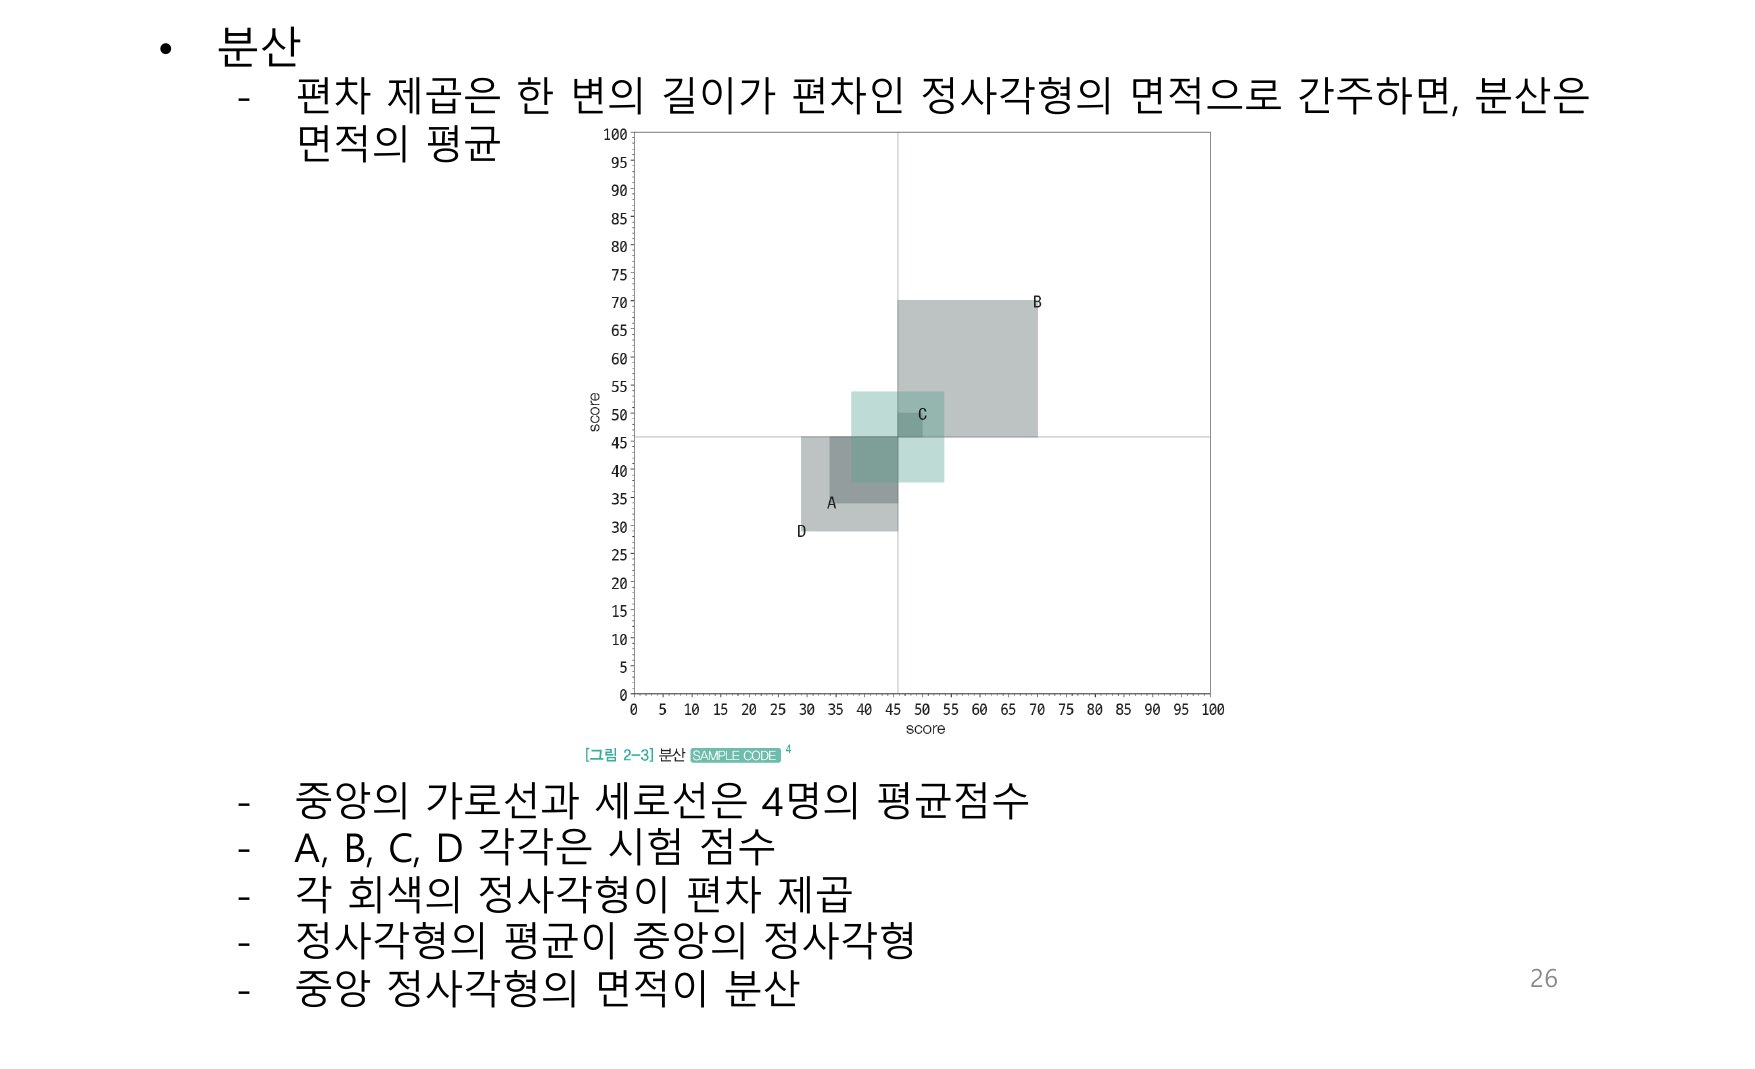
분산
- 산포도의 지표인 편차의 평균은 항상 0
- 앞의 B 학생과 D 학생은 모두 평균에서 14점 떨어져 동일 정도의 산포도를 가
지지만, 단순히 더하면 서로 상쇄되어 0이 되므로 편차의 제곱을 이용
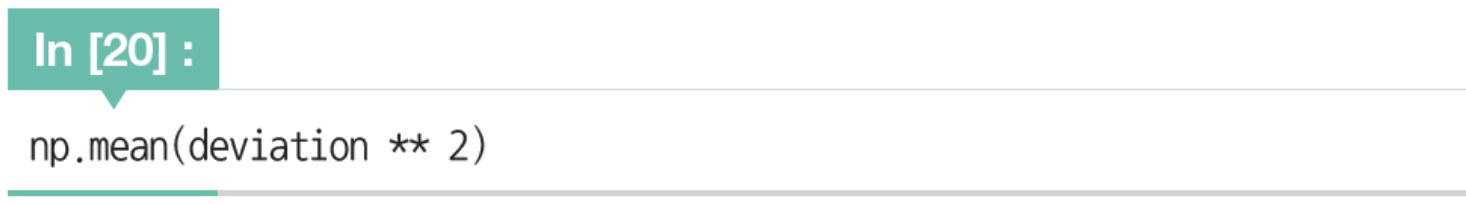
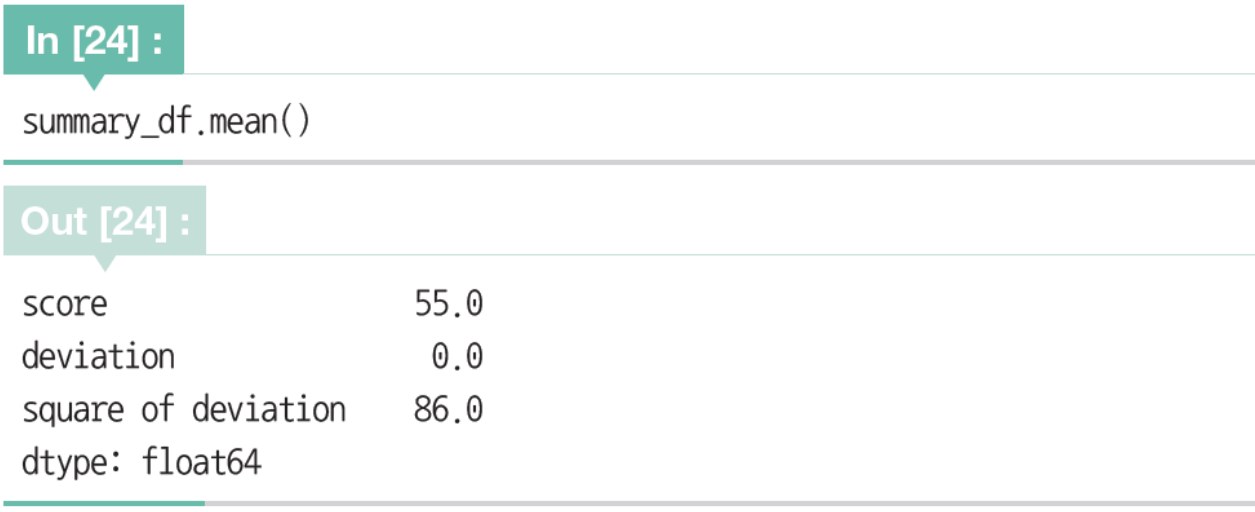
- 편차 제곱의 평균이 분산(모분산)
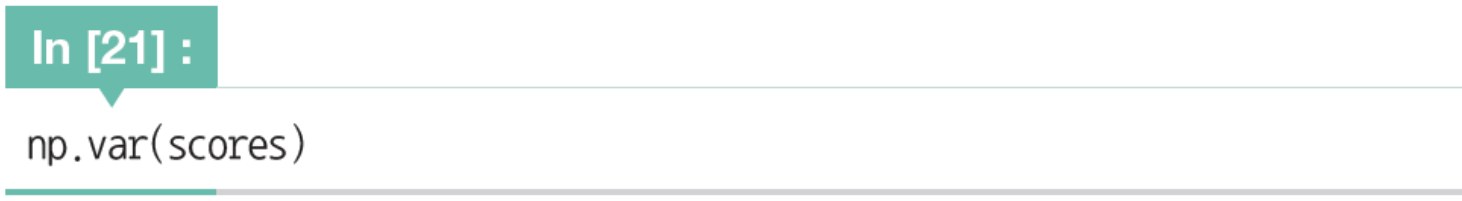
- NumPy의 var 함수
02주차 · 1차원 데이터 정리 — 지표 계산·시각화24
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화25
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화26
2.2 데이터의 산포도 지표

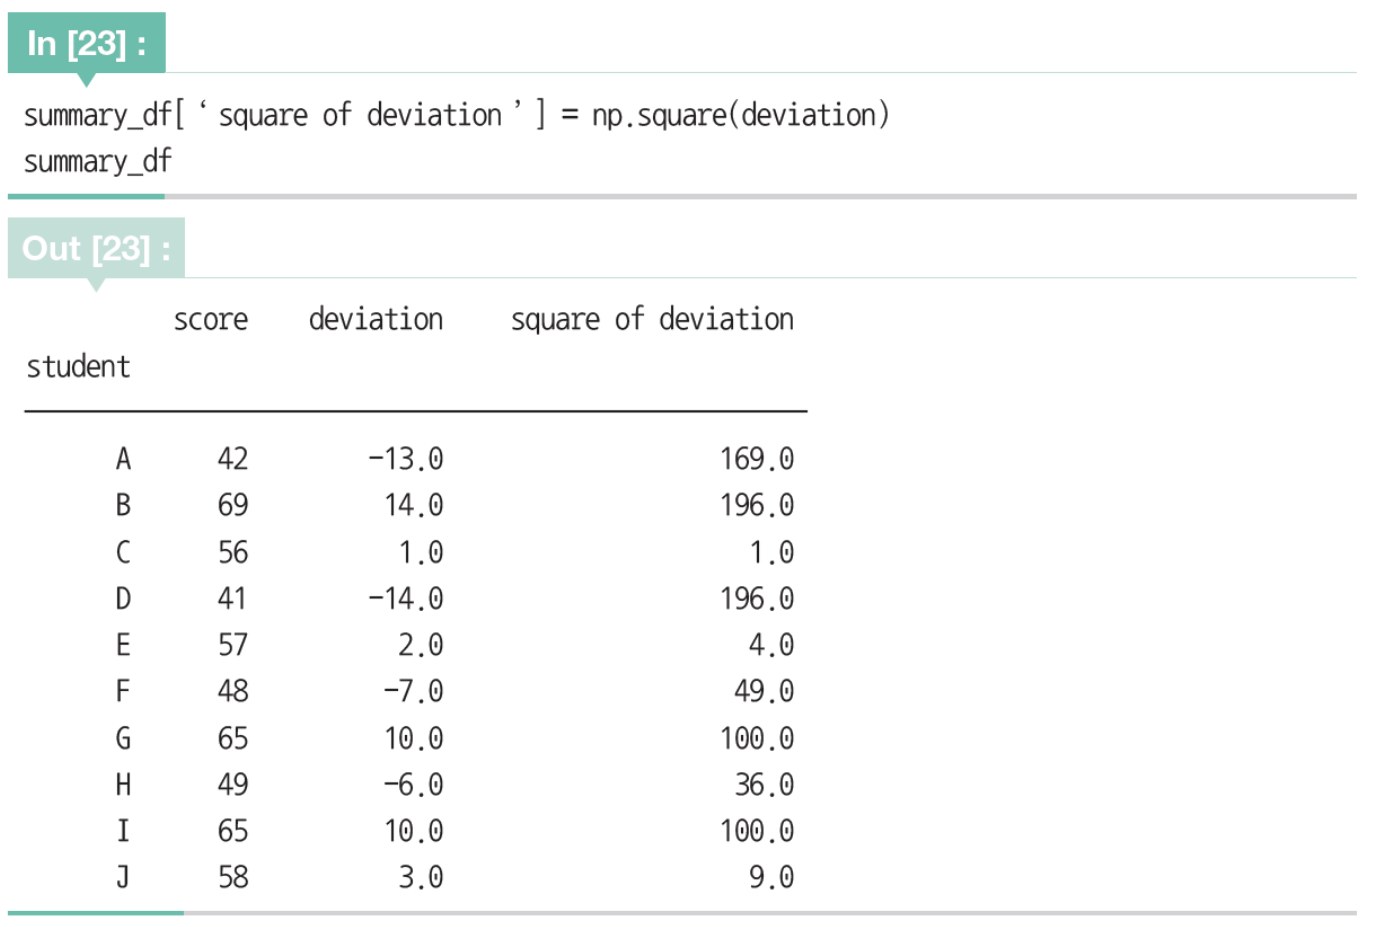
분산
- NumPy로 분산 계산
- summary_df에 편차의 제곱 열 추가
02주차 · 1차원 데이터 정리 — 지표 계산·시각화27
2.2 데이터의 산포도 지표

분산
- NumPy로 분산 계산
- summary_df에 편차의 제곱 열 추가
02주차 · 1차원 데이터 정리 — 지표 계산·시각화28
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화29
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화30
2.2 데이터의 산포도 지표

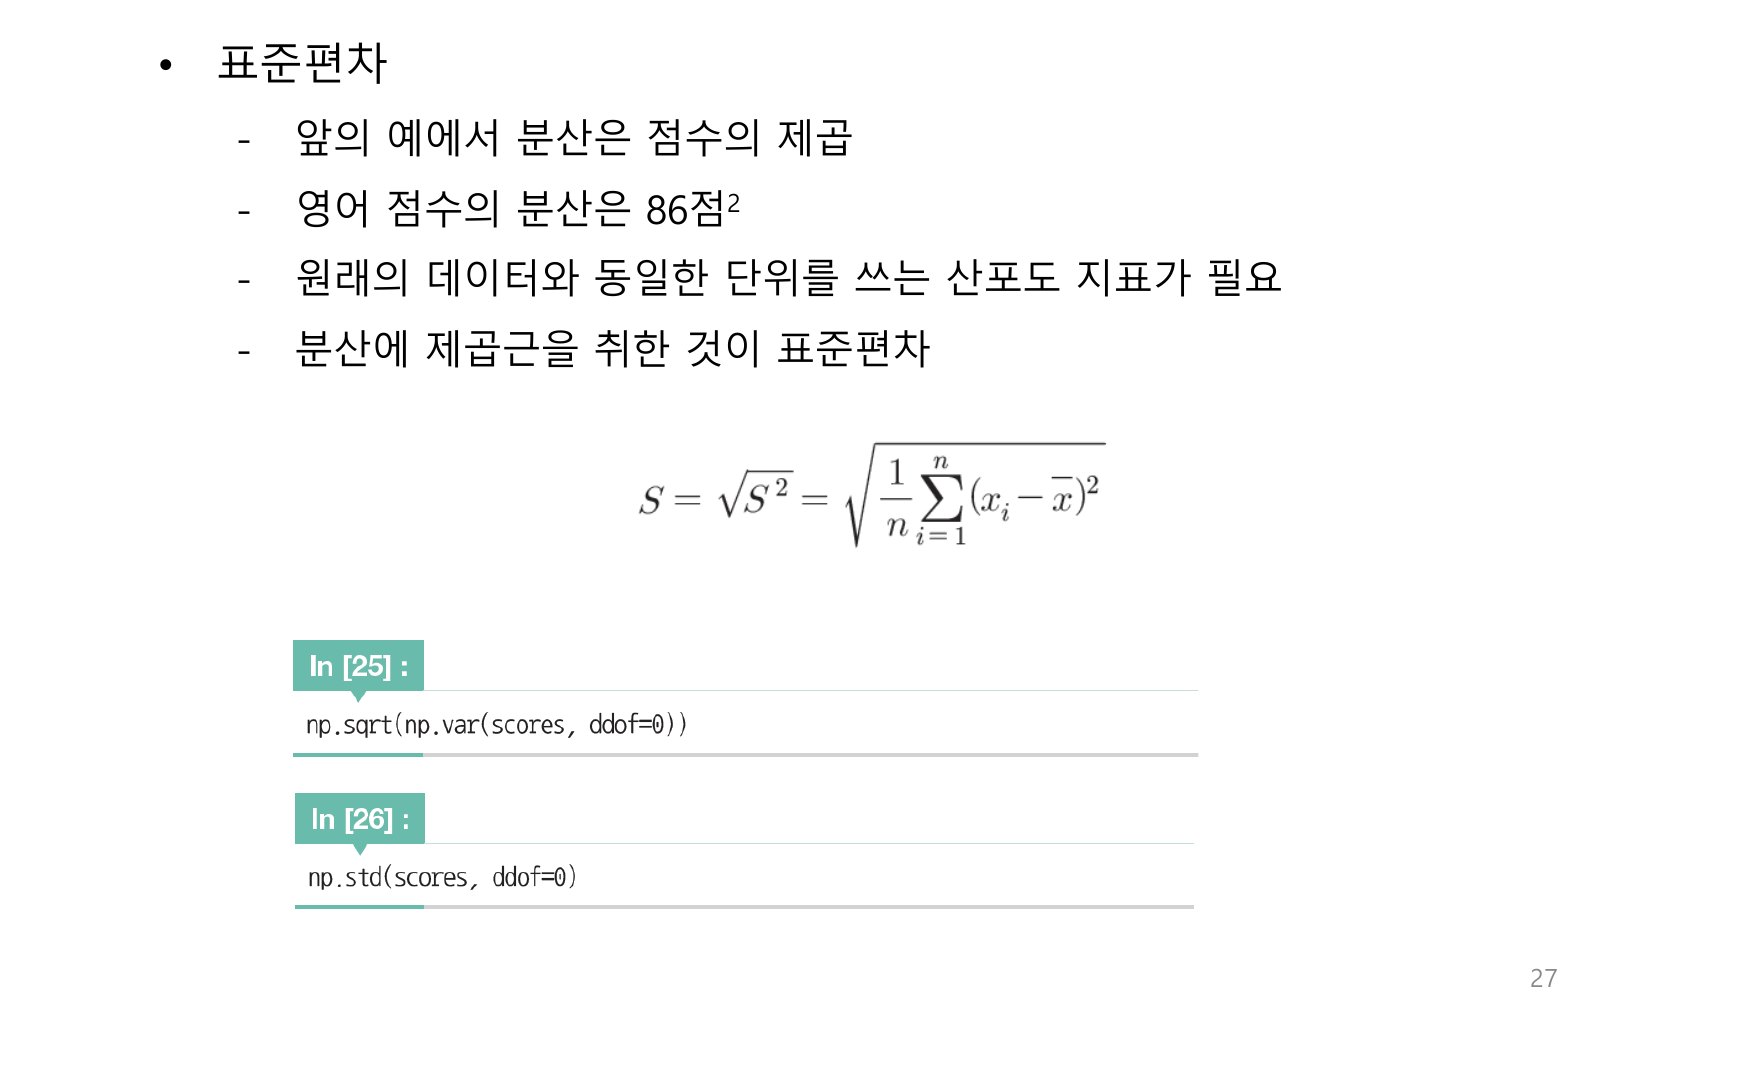
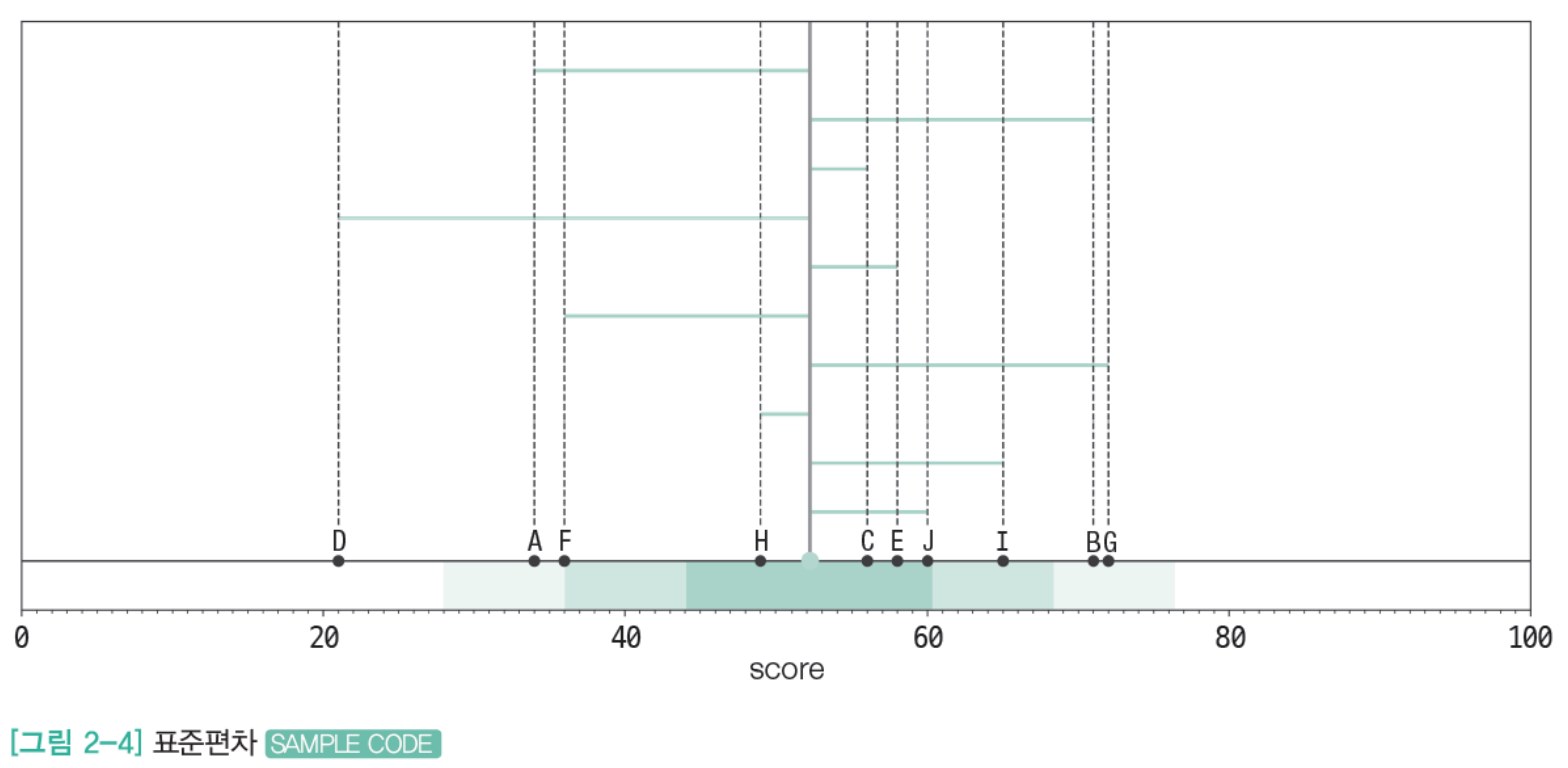
표준편차
- 원래 데이터와 동일한 단위이므로 동일 차원으로 그릴 수 있음
- 평균±표준편차, 평균±2표준편차, 평균±3표준편차
- 1시그마 구간, 2시그마 구간, 3시그마 구간
02주차 · 1차원 데이터 정리 — 지표 계산·시각화31
2.2 데이터의 산포도 지표


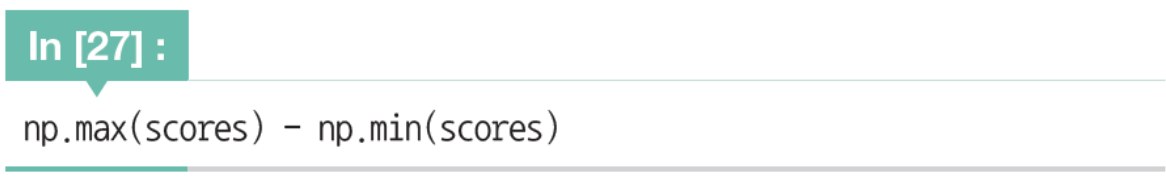
범위
- 데이터 전체가 아니라 최댓값과 최솟값만으로 산포도 표현
02주차 · 1차원 데이터 정리 — 지표 계산·시각화32
2.2 데이터의 산포도 지표


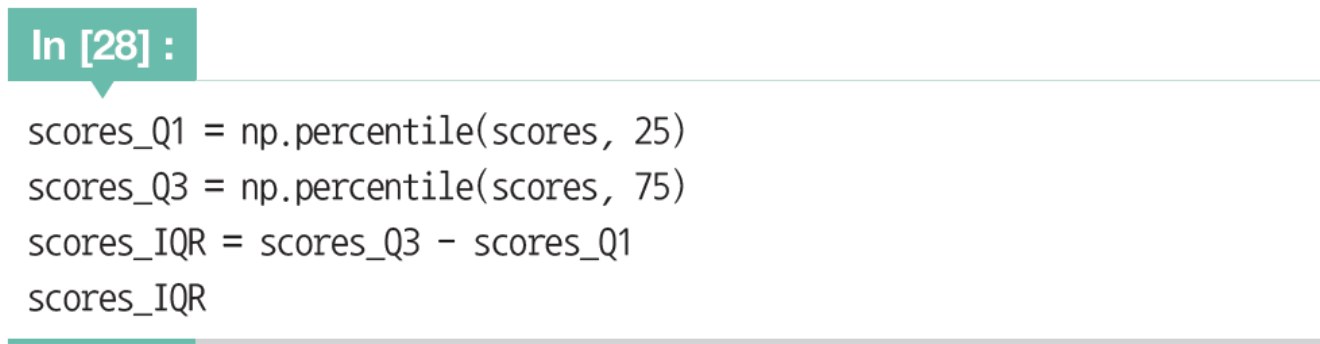
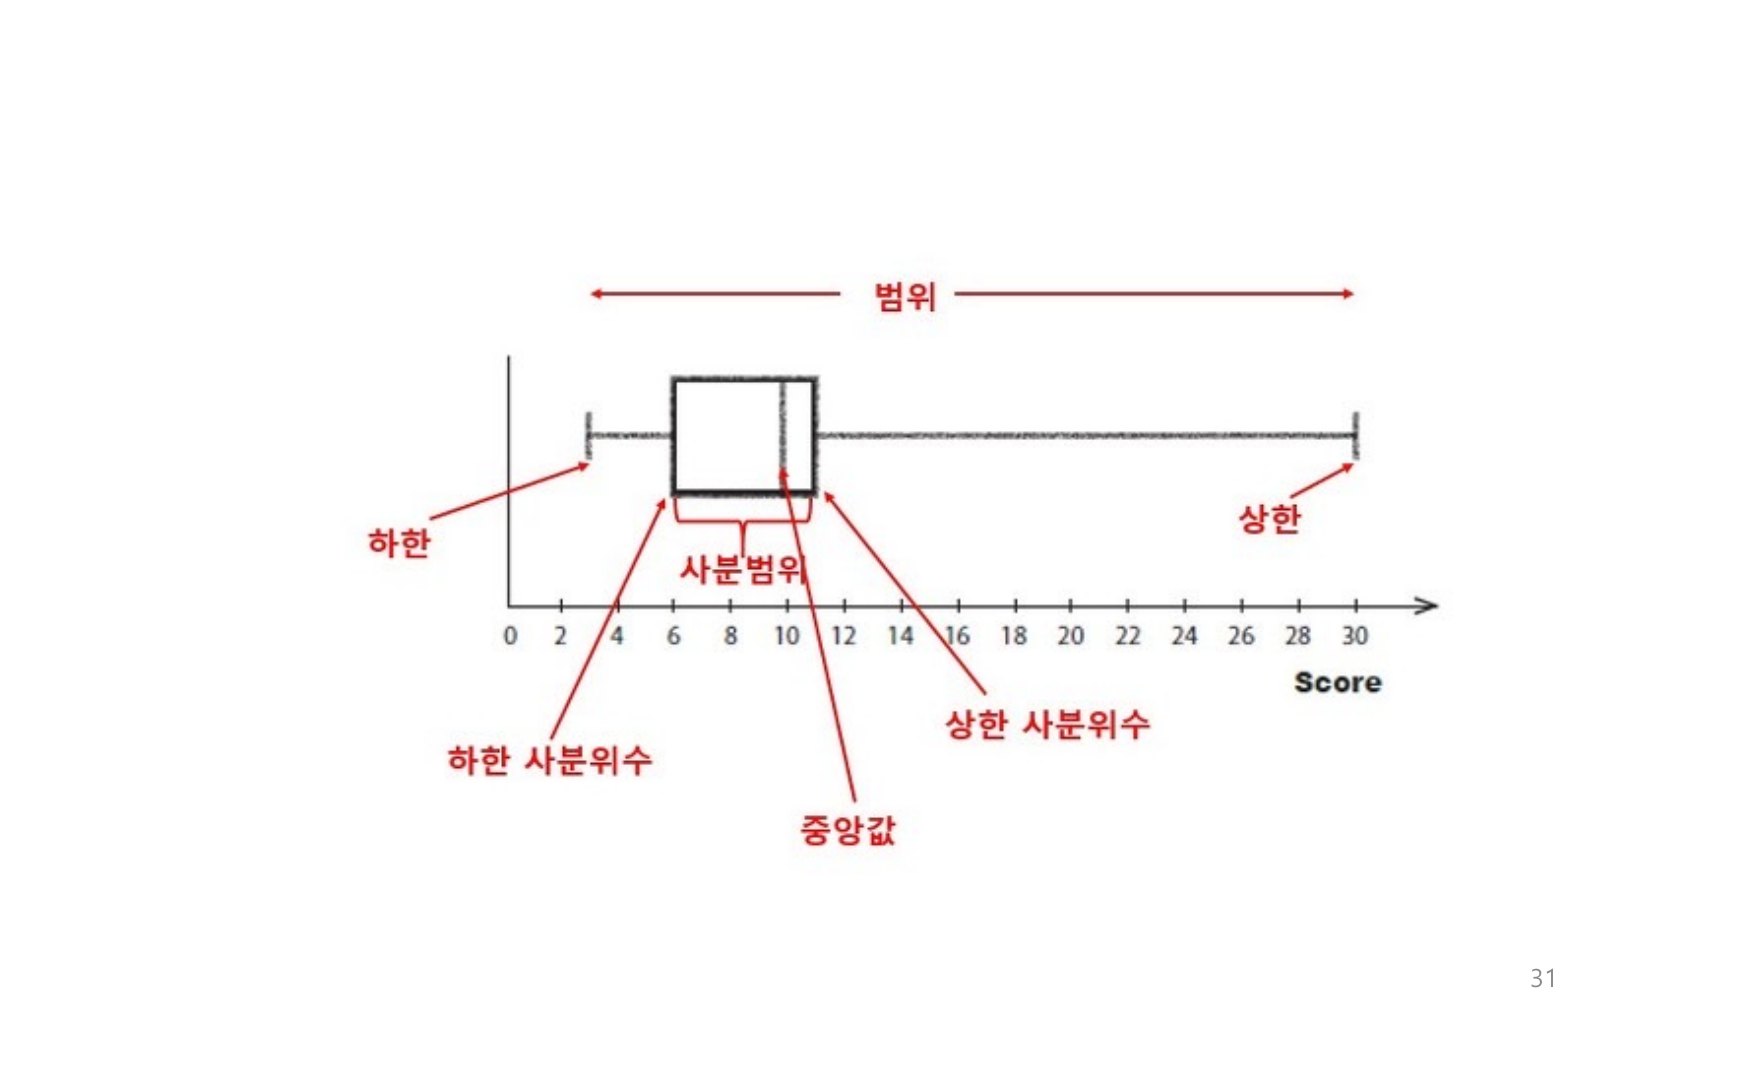
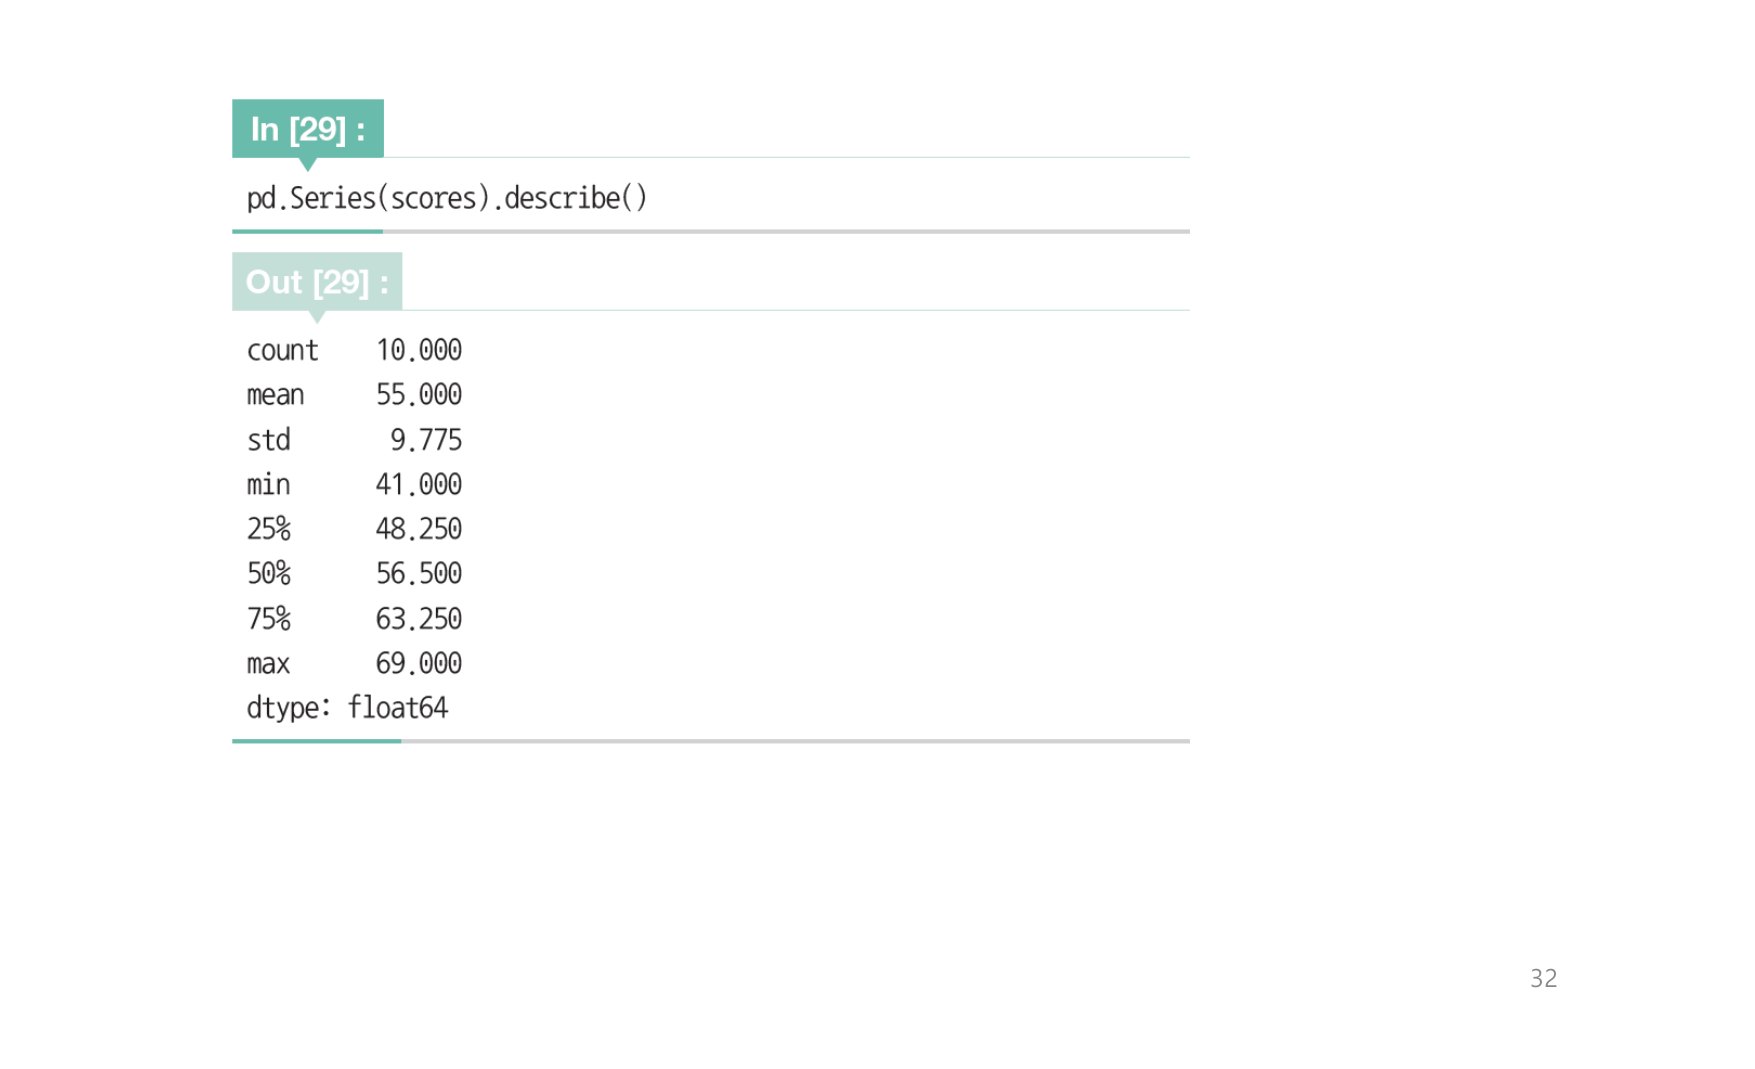
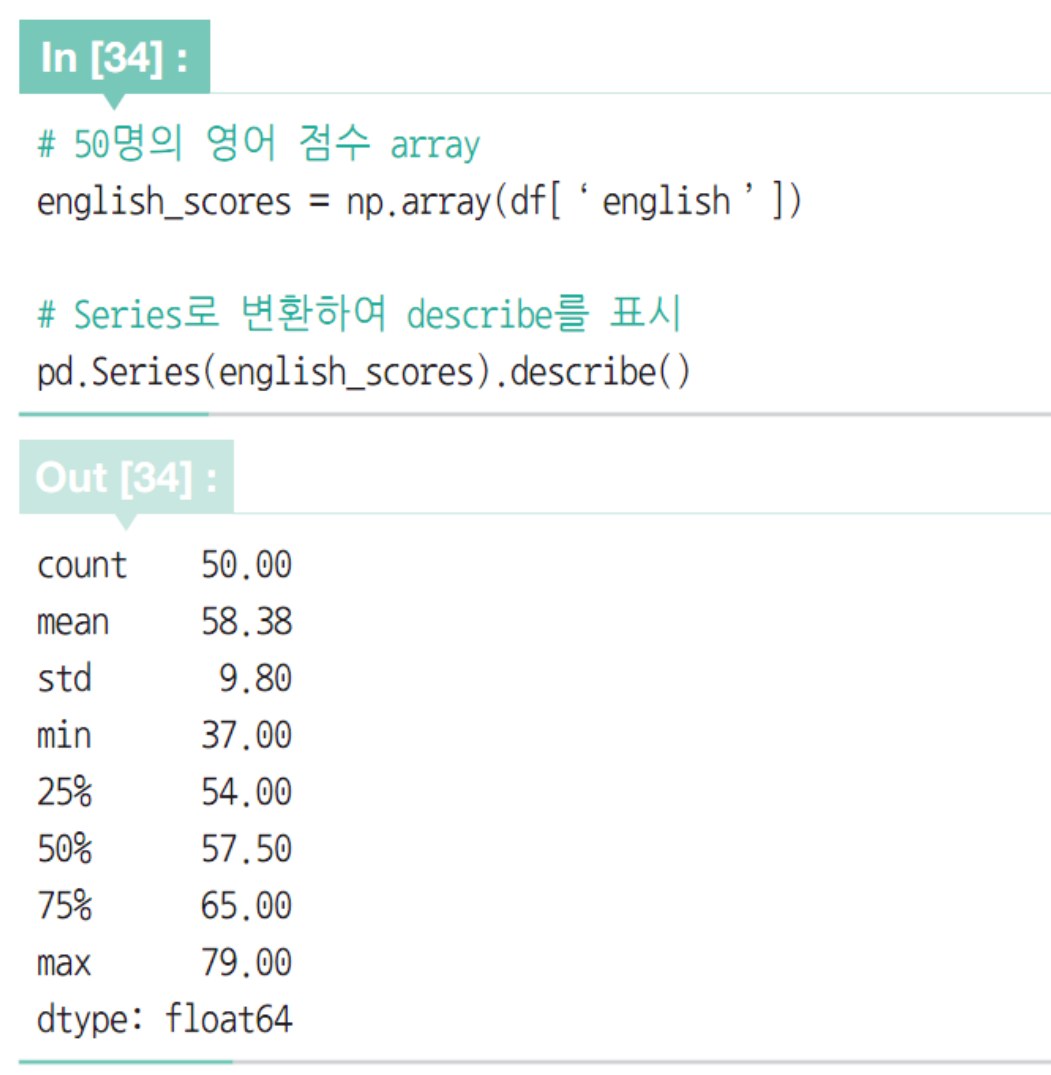
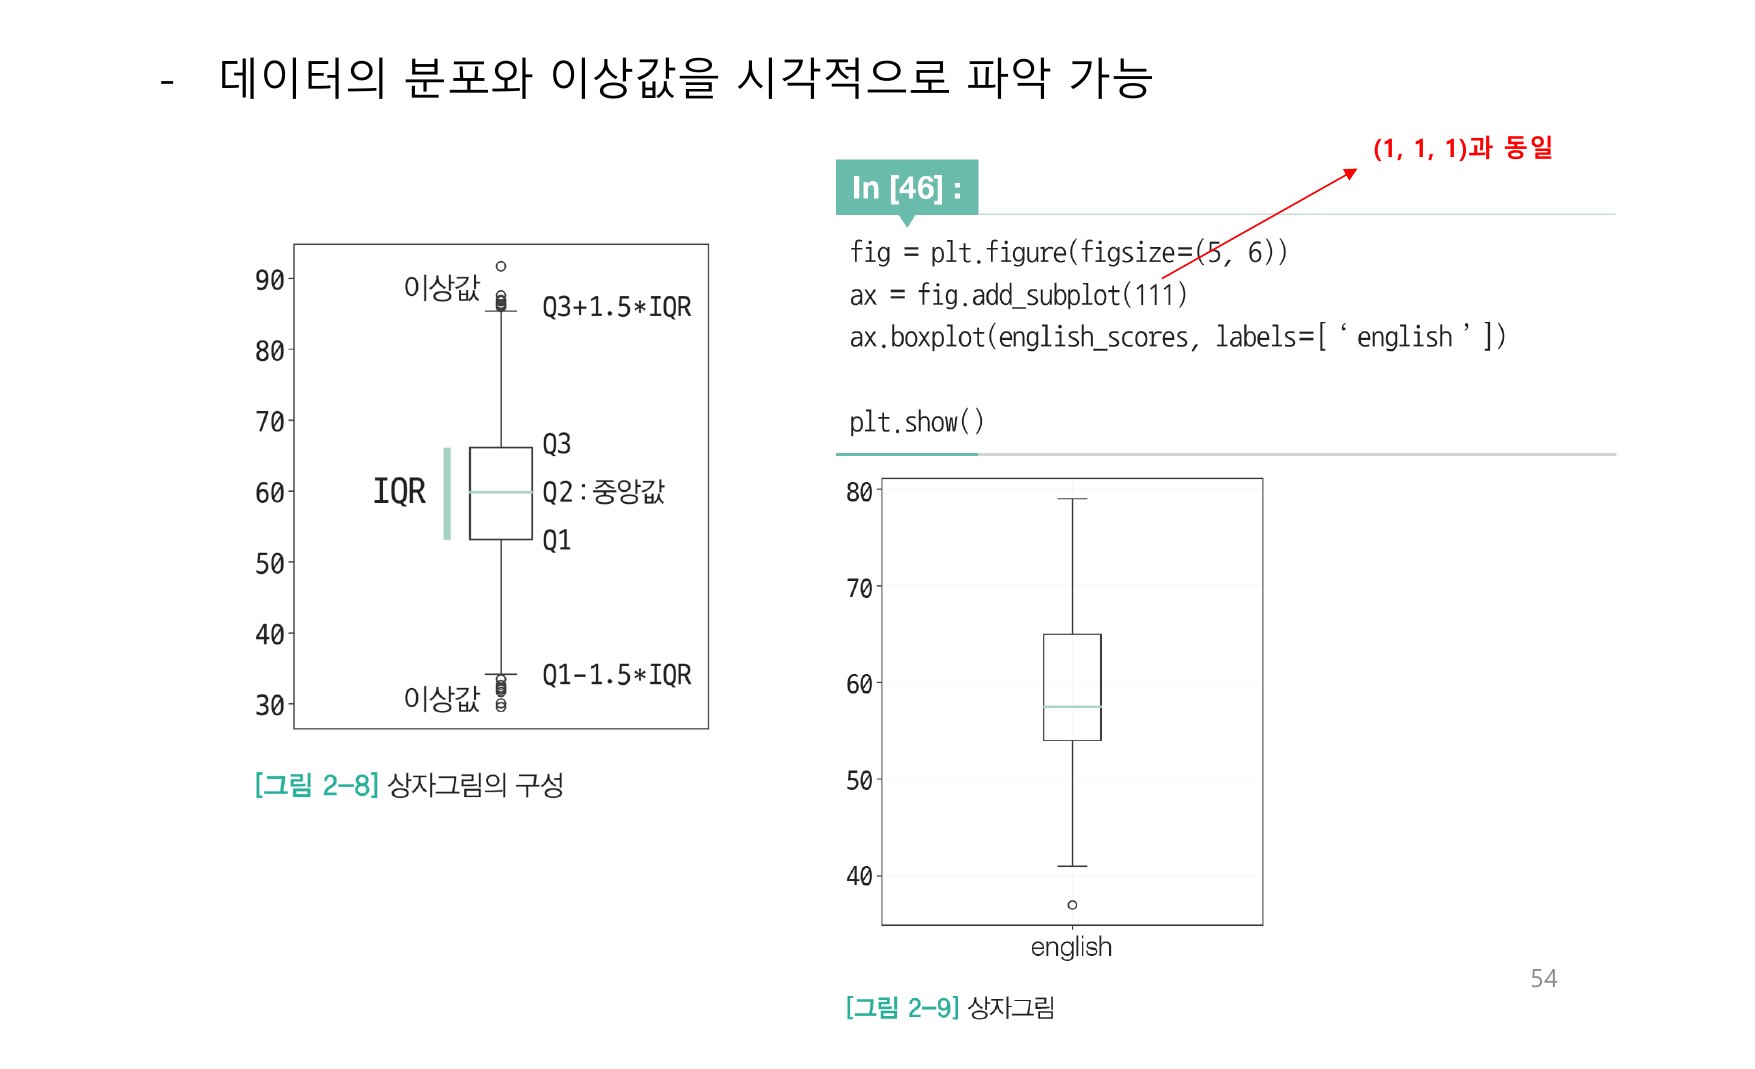
사분위 범위
- 상위수%와 하위수%에 위치하는 값의 차이
- 데이터의 하위 25%, 50%, 75%에 위치하는 값은 각각 제1사분위수(Q1), 제
2사분위수(Q2), 제3사분위수(Q3)
- 사분위 범위
02주차 · 1차원 데이터 정리 — 지표 계산·시각화33
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화34
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화35
2.2 데이터의 산포도 지표

02주차 · 1차원 데이터 정리 — 지표 계산·시각화36
2.3 데이터의 정규화


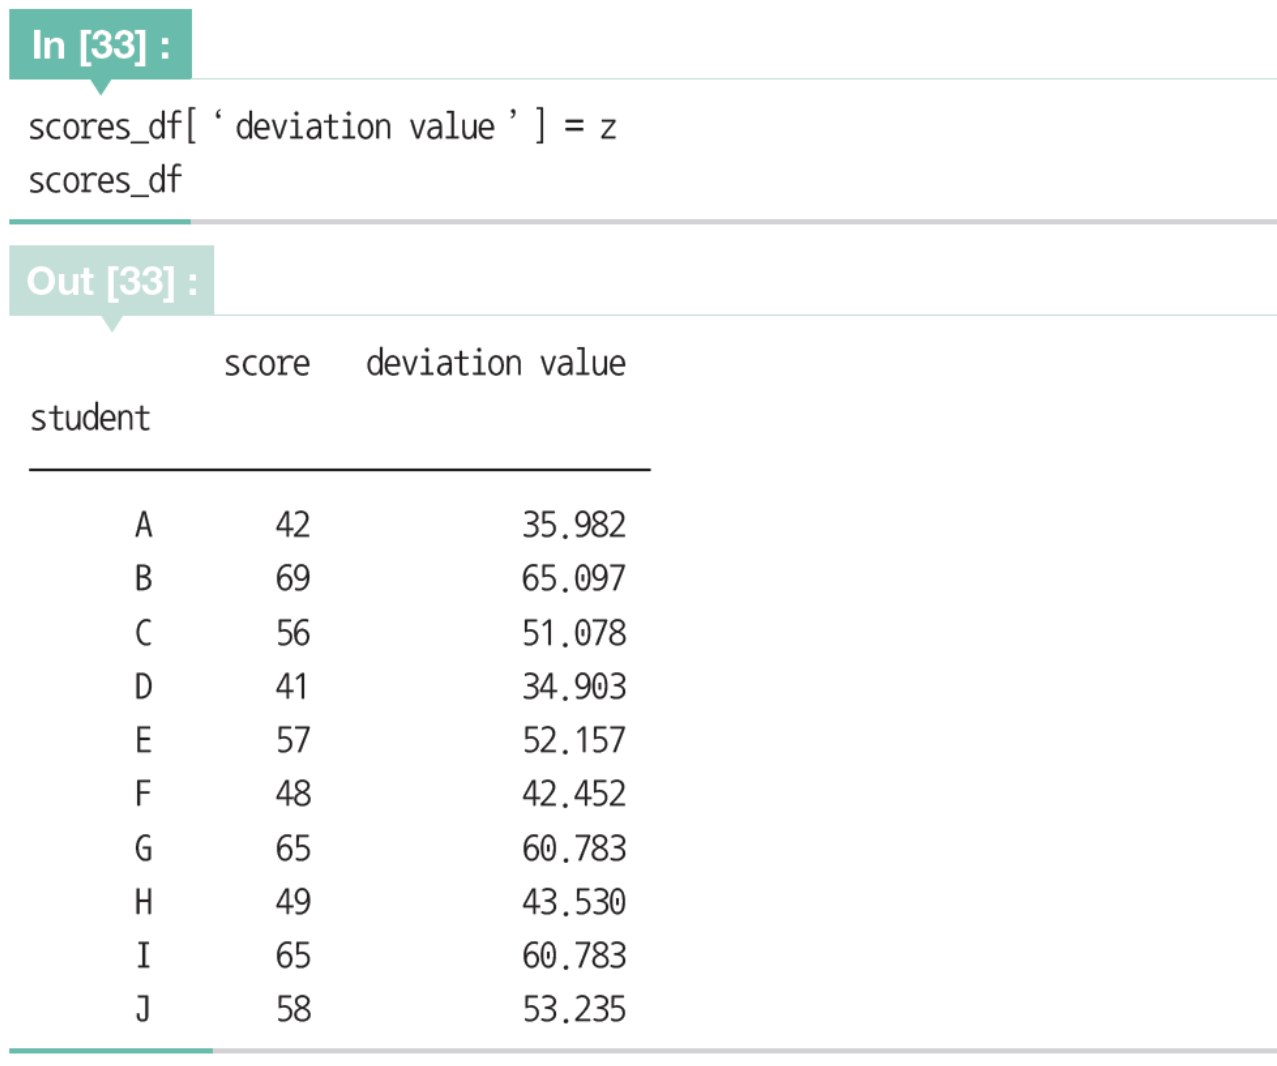
표준화
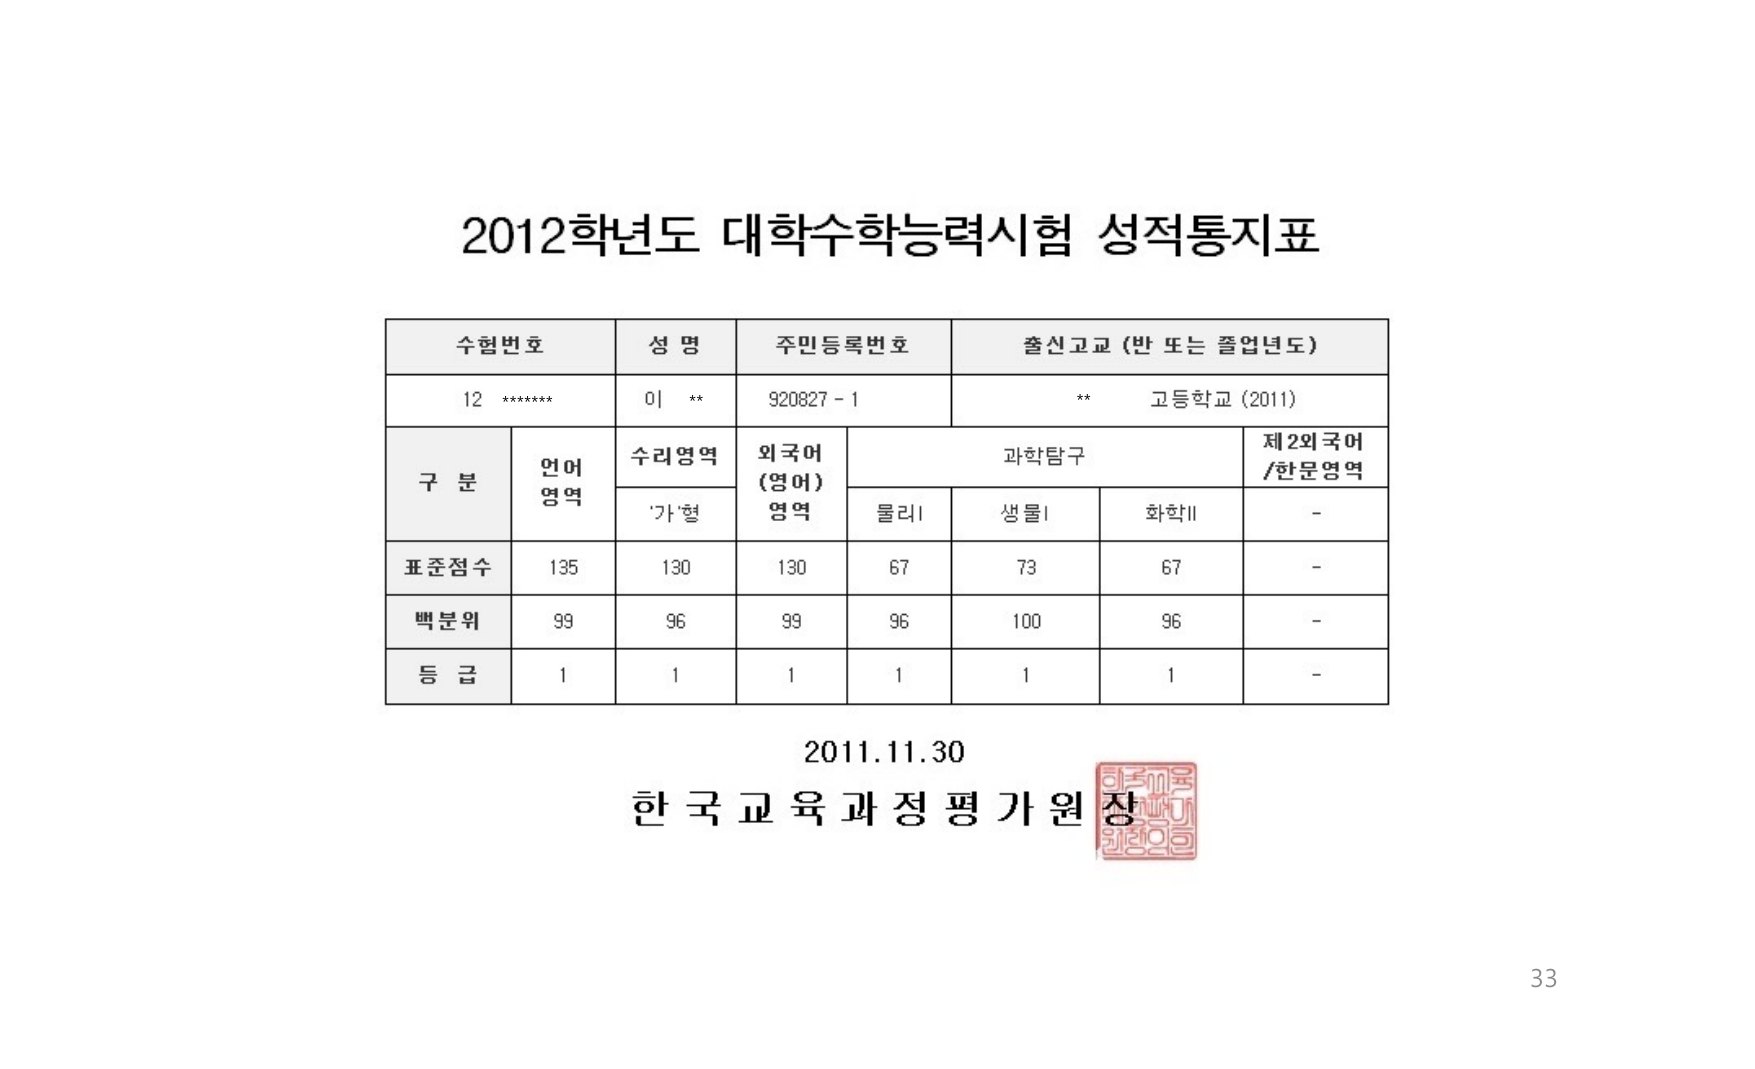
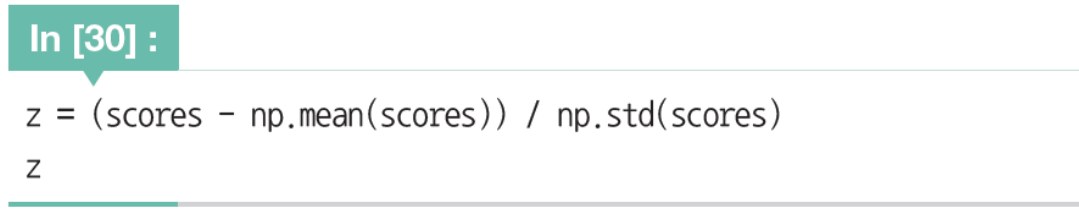
- 상대적 결과가 다르므로 통일된 지표로 변환하는 정규화
- 데이터에서 평균을 빼고 표준편차로 나누는 작업
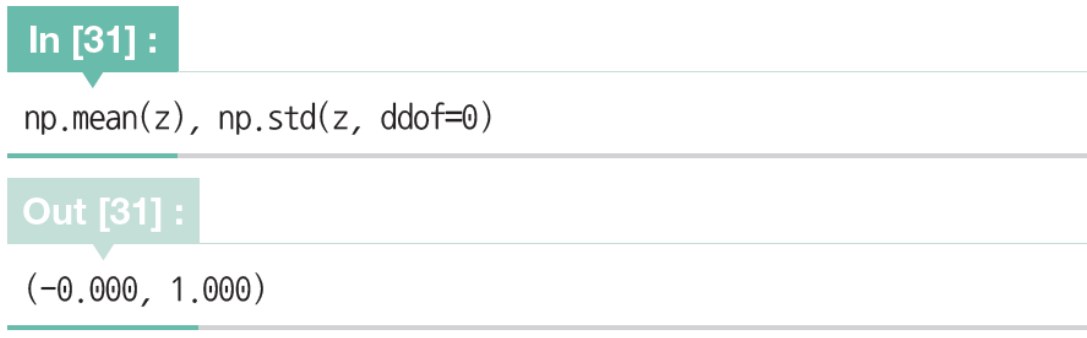
- 표준화된 데이터는 표준화 변량 혹은 Z 점수
- 표준화된 데이터는 평균이 0, 표준편차가 1
02주차 · 1차원 데이터 정리 — 지표 계산·시각화37
2.3 데이터의 정규화


편찻값
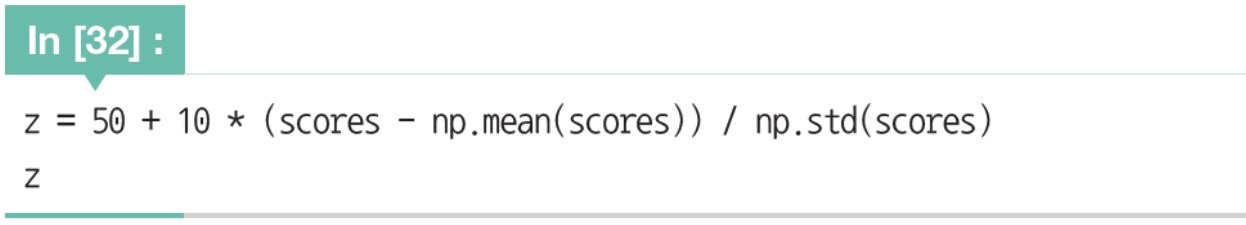
- 평균이 50, 표준편차가 10이 되도록 정규화한 값
02주차 · 1차원 데이터 정리 — 지표 계산·시각화38
2.3 데이터의 정규화


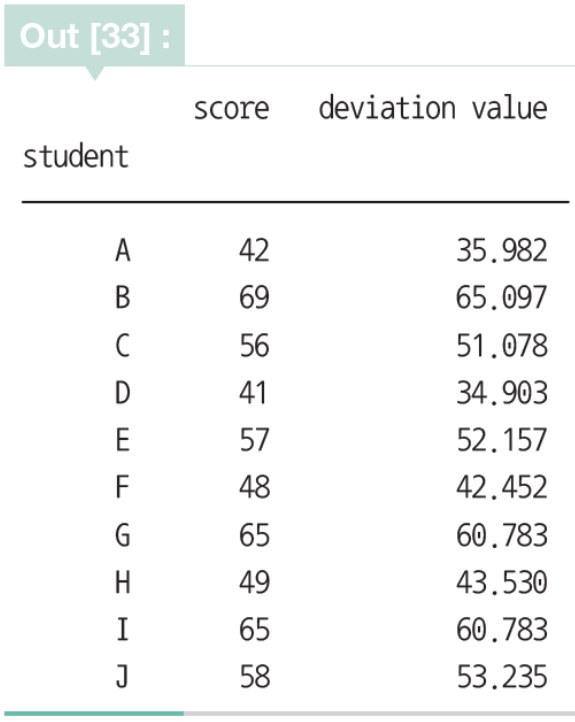
점수와 편찻값의 관계
- 어떤 학생이 평균 성적을 얻었고, 어떤 학생이
우수한 성적을 얻었는지 알 수 있음
02주차 · 1차원 데이터 정리 — 지표 계산·시각화39
2.4 1차원 데이터의 시각화

데이터의 주요 지표
02주차 · 1차원 데이터 정리 — 지표 계산·시각화40
2.4 1차원 데이터의 시각화

데이터의 주요 지표
02주차 · 1차원 데이터 정리 — 지표 계산·시각화41
2.4 1차원 데이터의 시각화

참고: https://blog.naver.com/hwasinedu/222065642328
39
02주차 · 1차원 데이터 정리 — 지표 계산·시각화42
2.4 1차원 데이터의 시각화

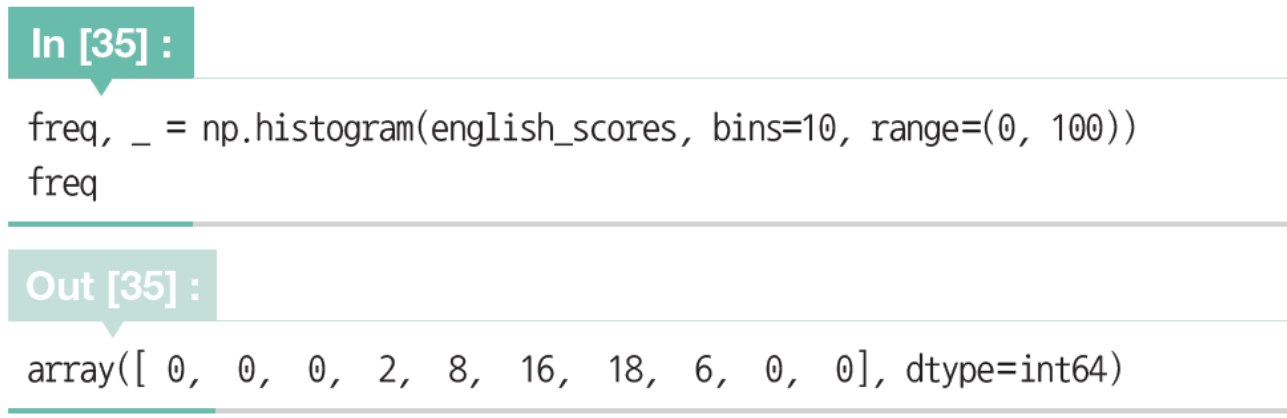
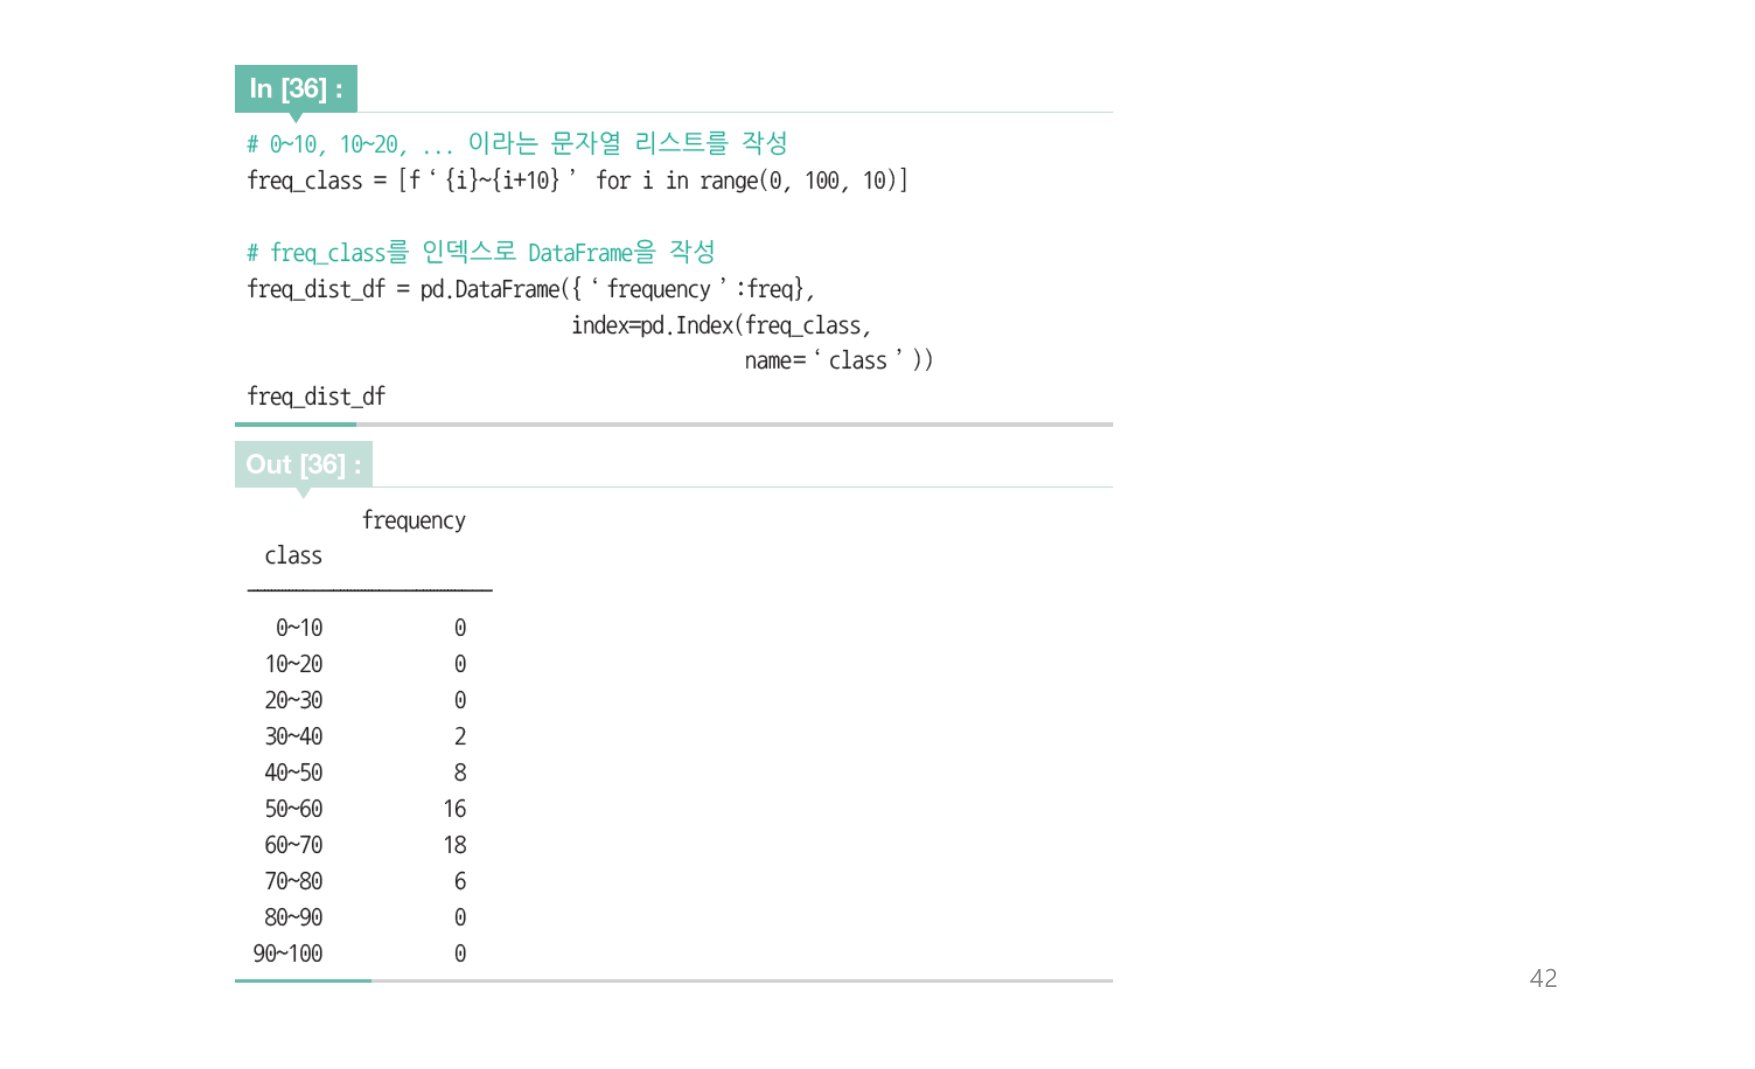
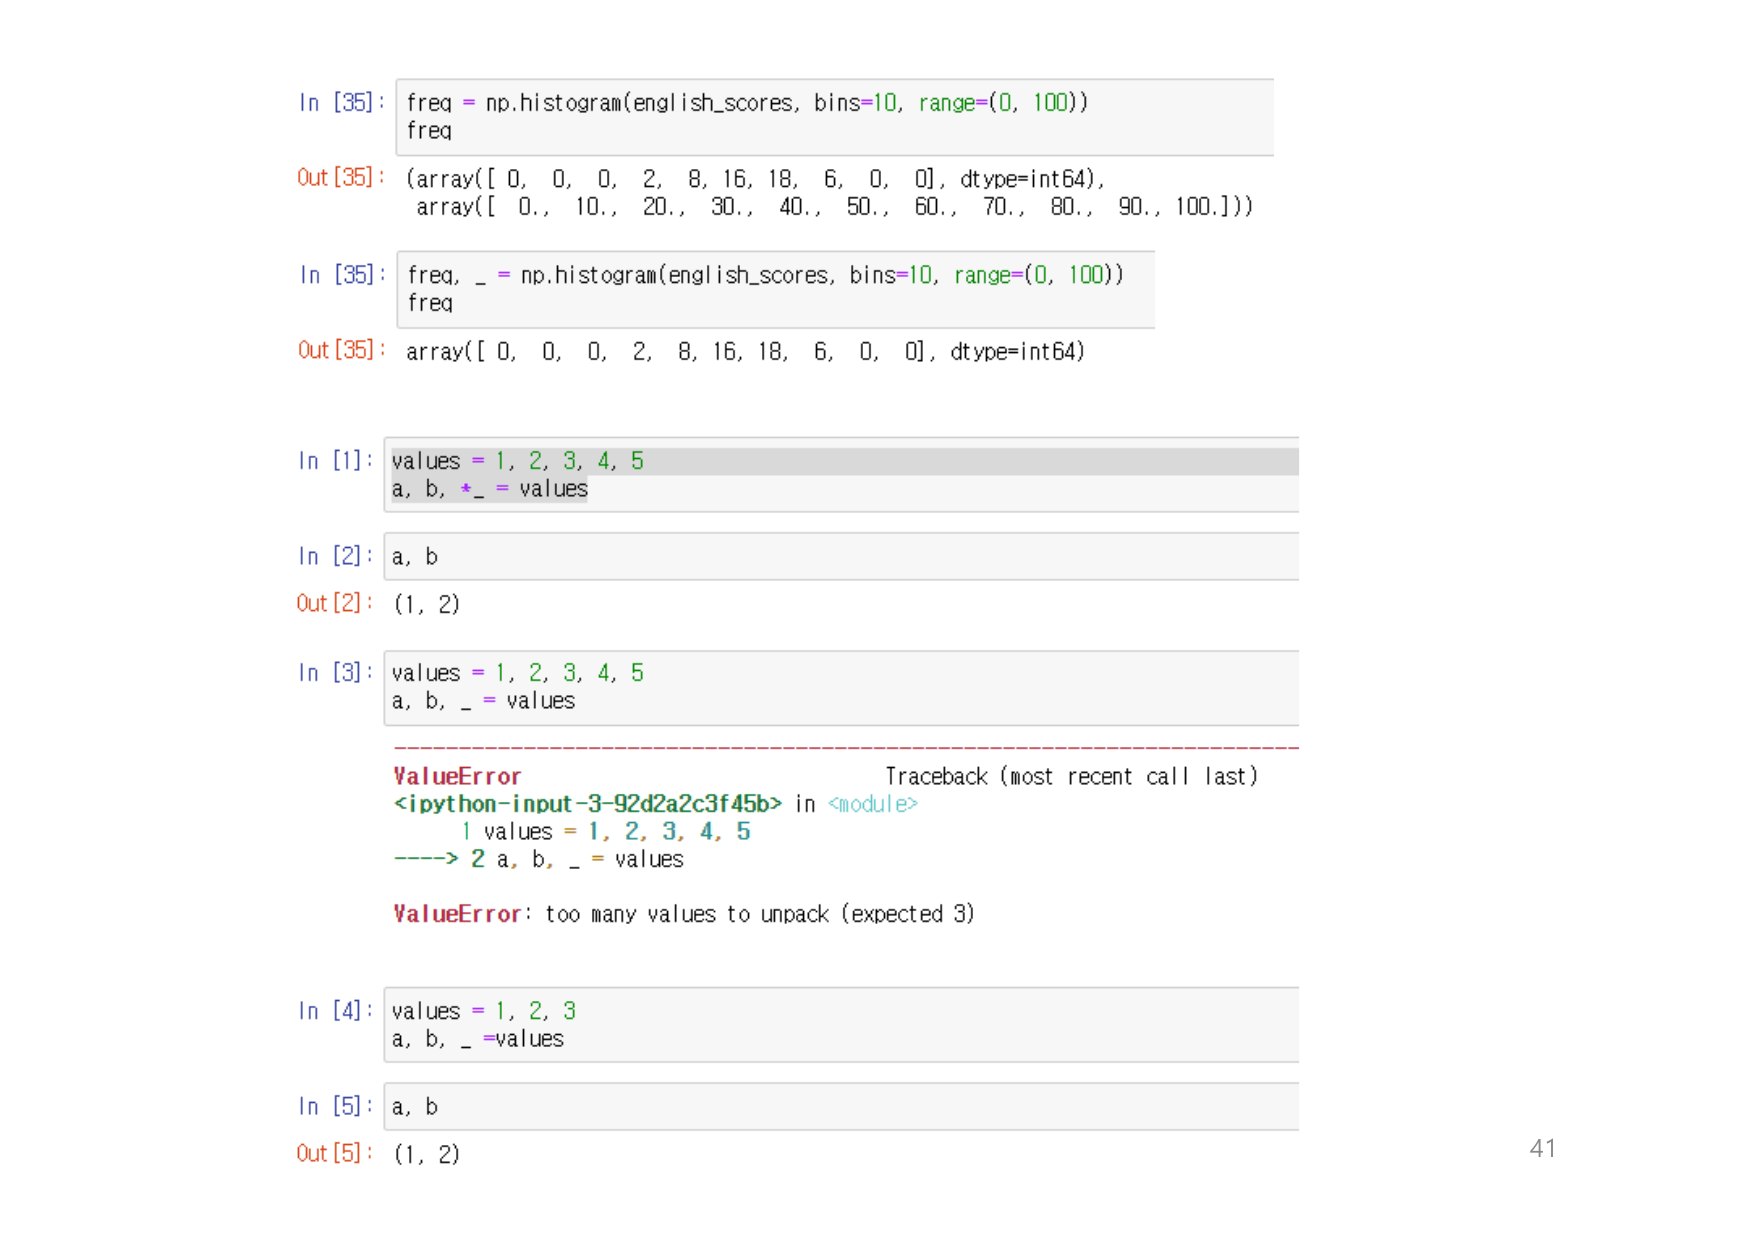
데이터의 분포 상태를 세부적으로 알고 싶을 때, 데이터가 취하는 값을
몇 개의 구간으로 나누고, 각 구간에 몇 개의 데이터가 들어가는가를 세
는 방법
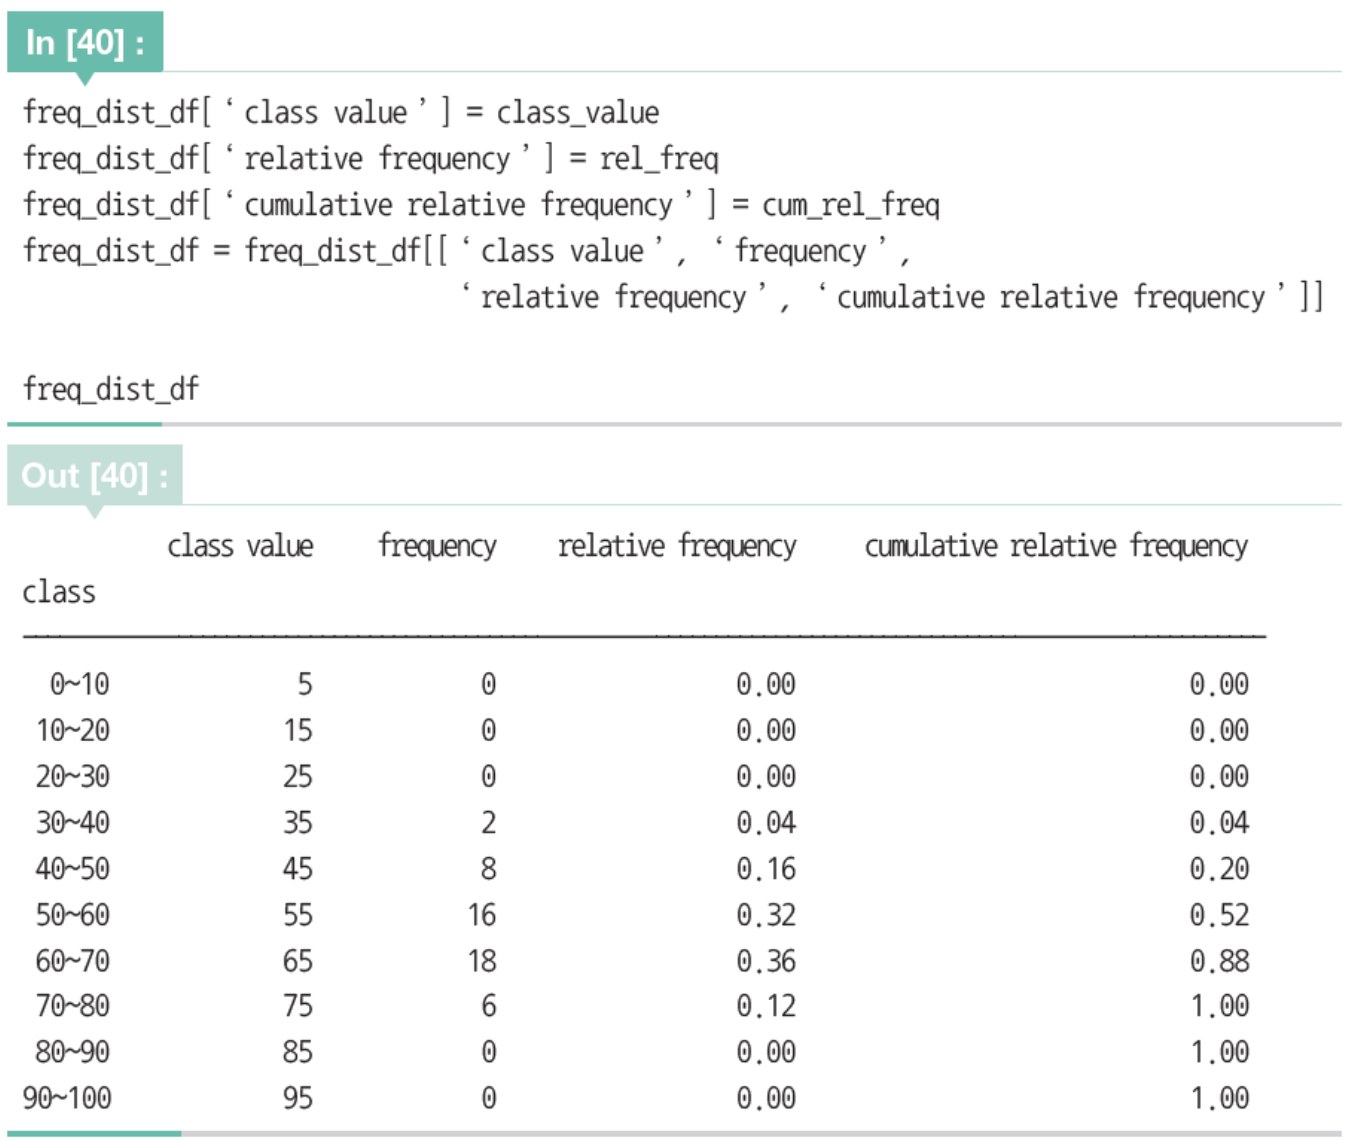
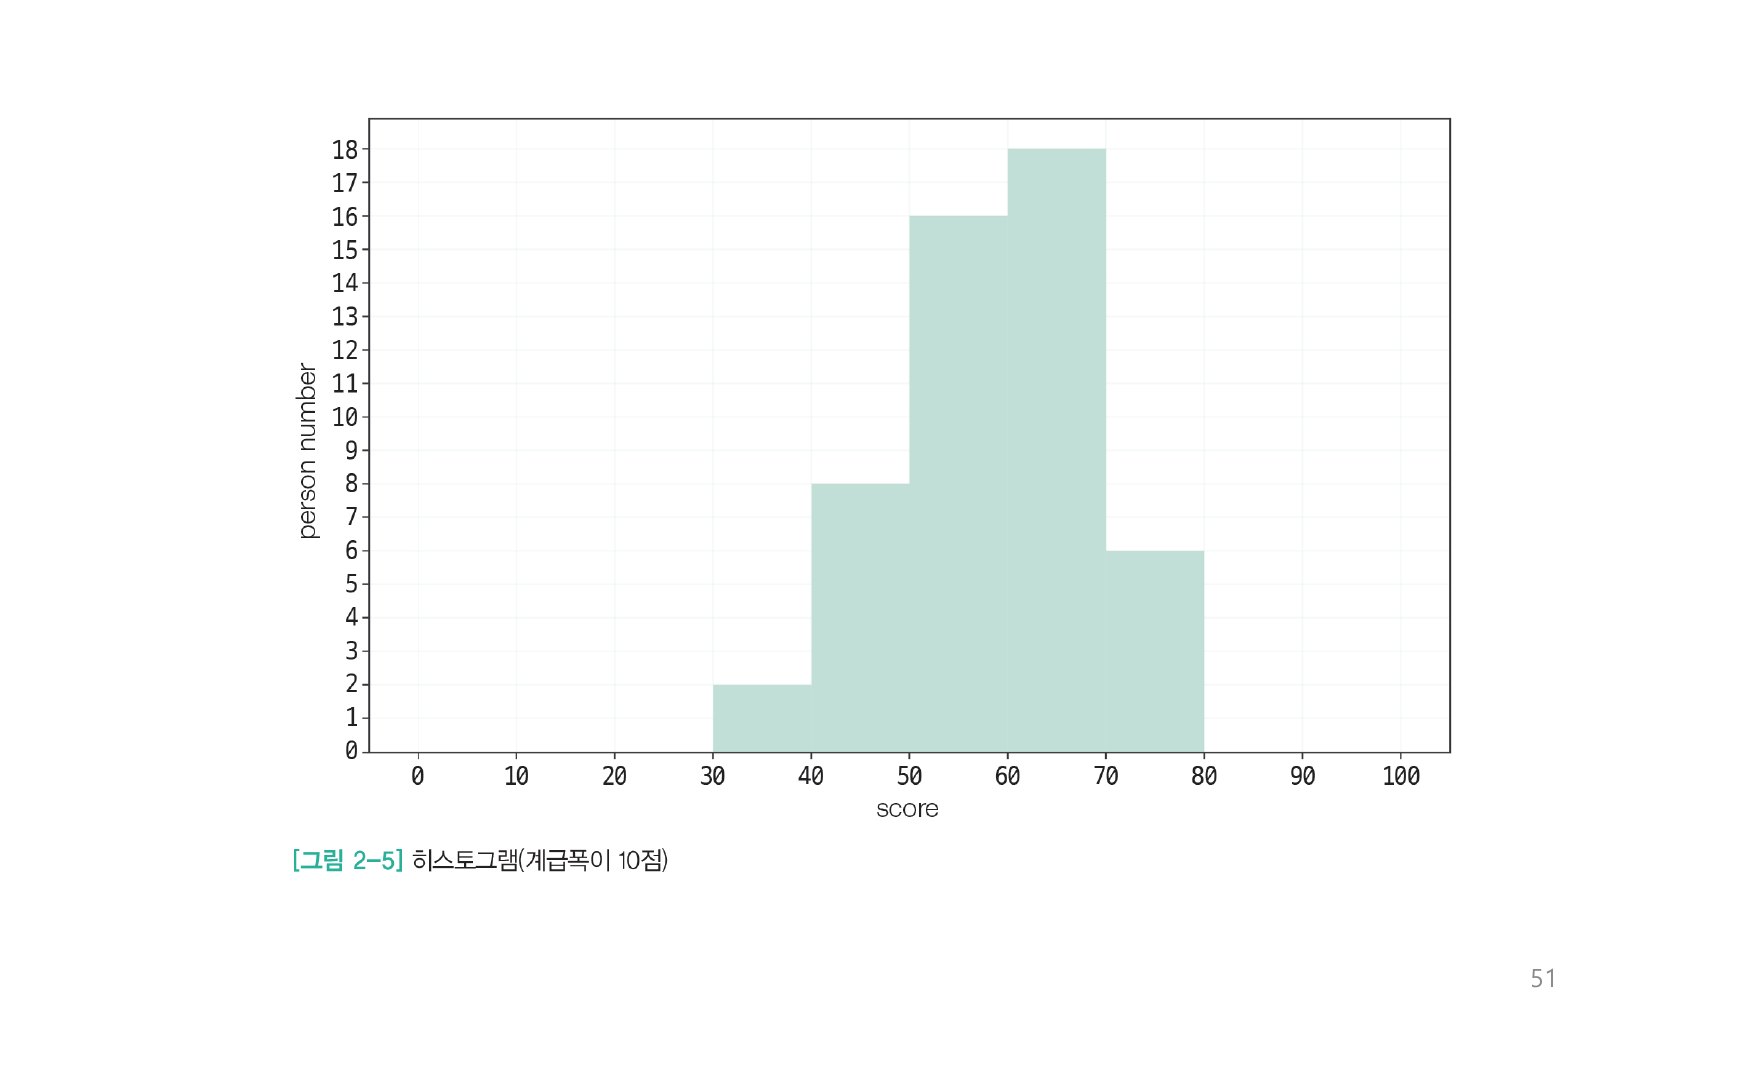
분할된 구간과 데이터의 개수를 정리한 표가 도수분포표
- 계급: 시험 점수를 10점 간격으로 나눌 때 0~10점 구간 등
- 도수: 각 계급에 속한 학생 수
- 계급폭: 각 구간의 폭, 10점
- 계급수: 계급의 수, 10
02주차 · 1차원 데이터 정리 — 지표 계산·시각화43

02주차 · 1차원 데이터 정리 — 지표 계산·시각화44
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화45
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화46
2.4 1차원 데이터의 시각화

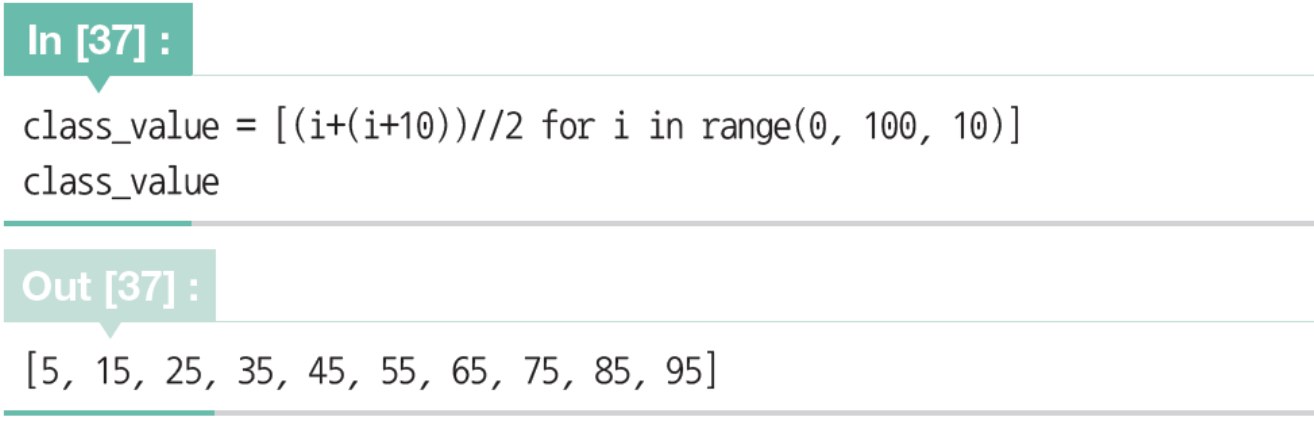
계급값
- 각 계급을 대표하는 값으로, 계급의 중앙값을 이용
02주차 · 1차원 데이터 정리 — 지표 계산·시각화47
2.4 1차원 데이터의 시각화

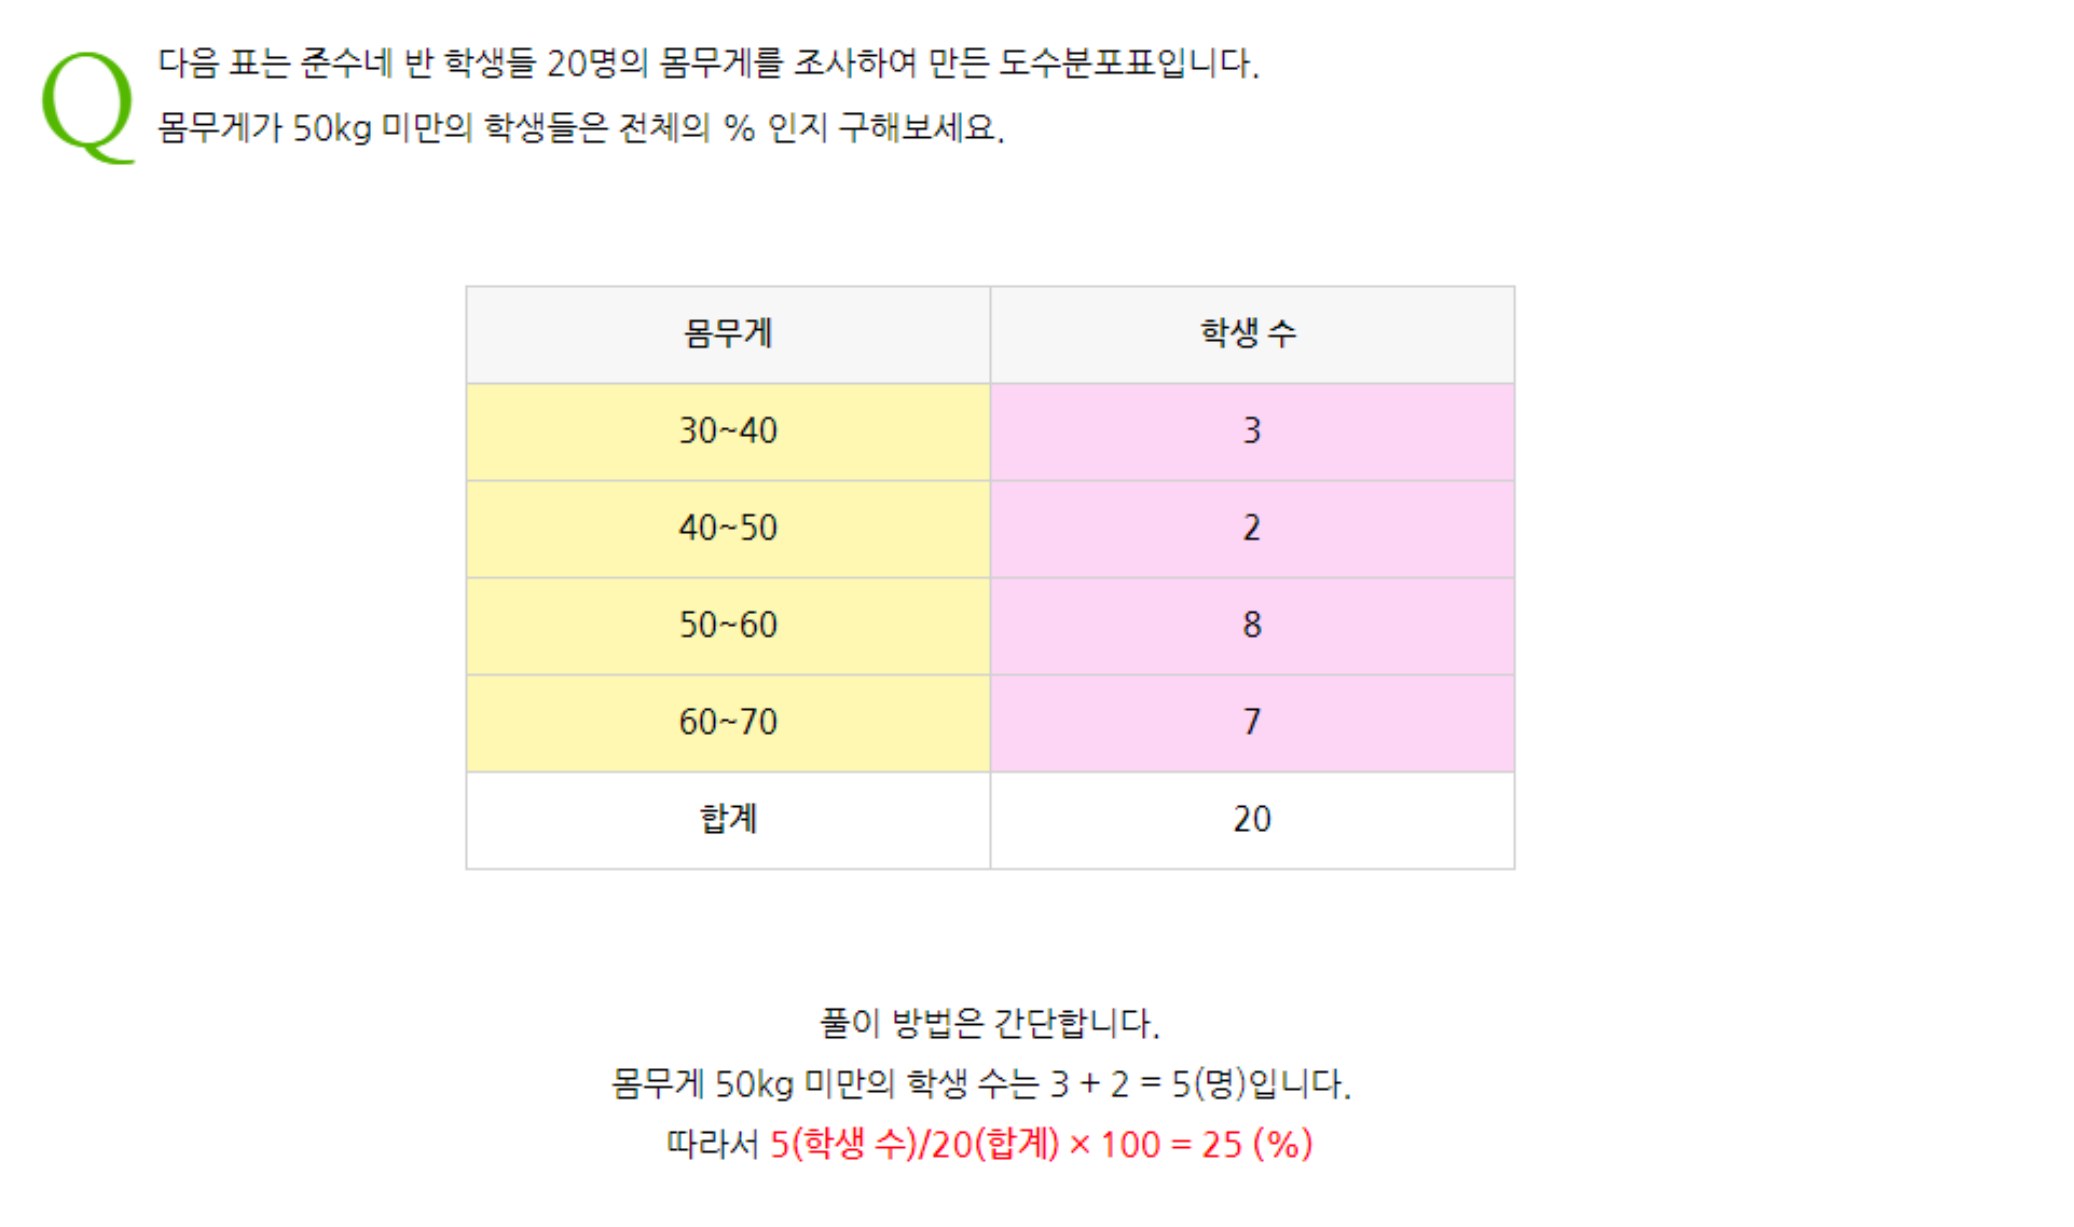
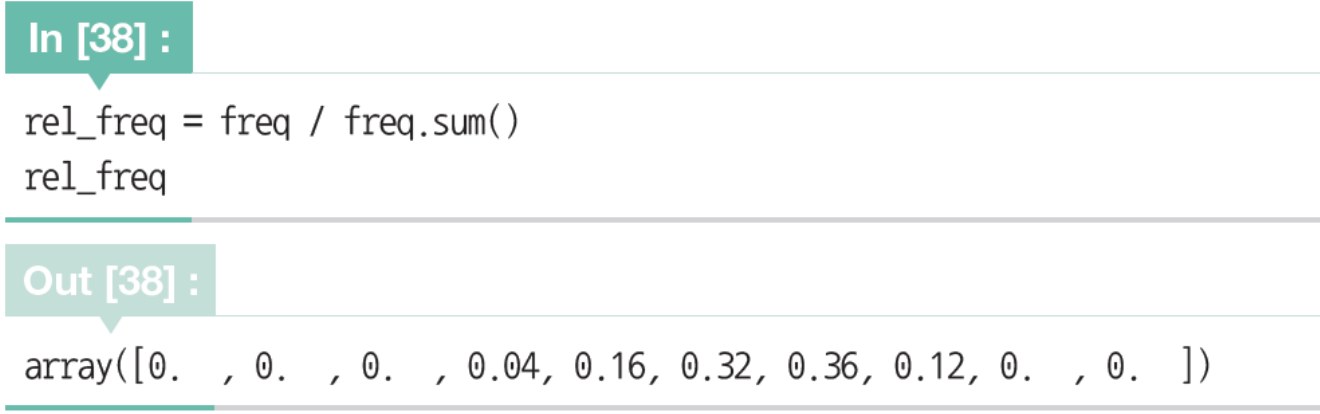
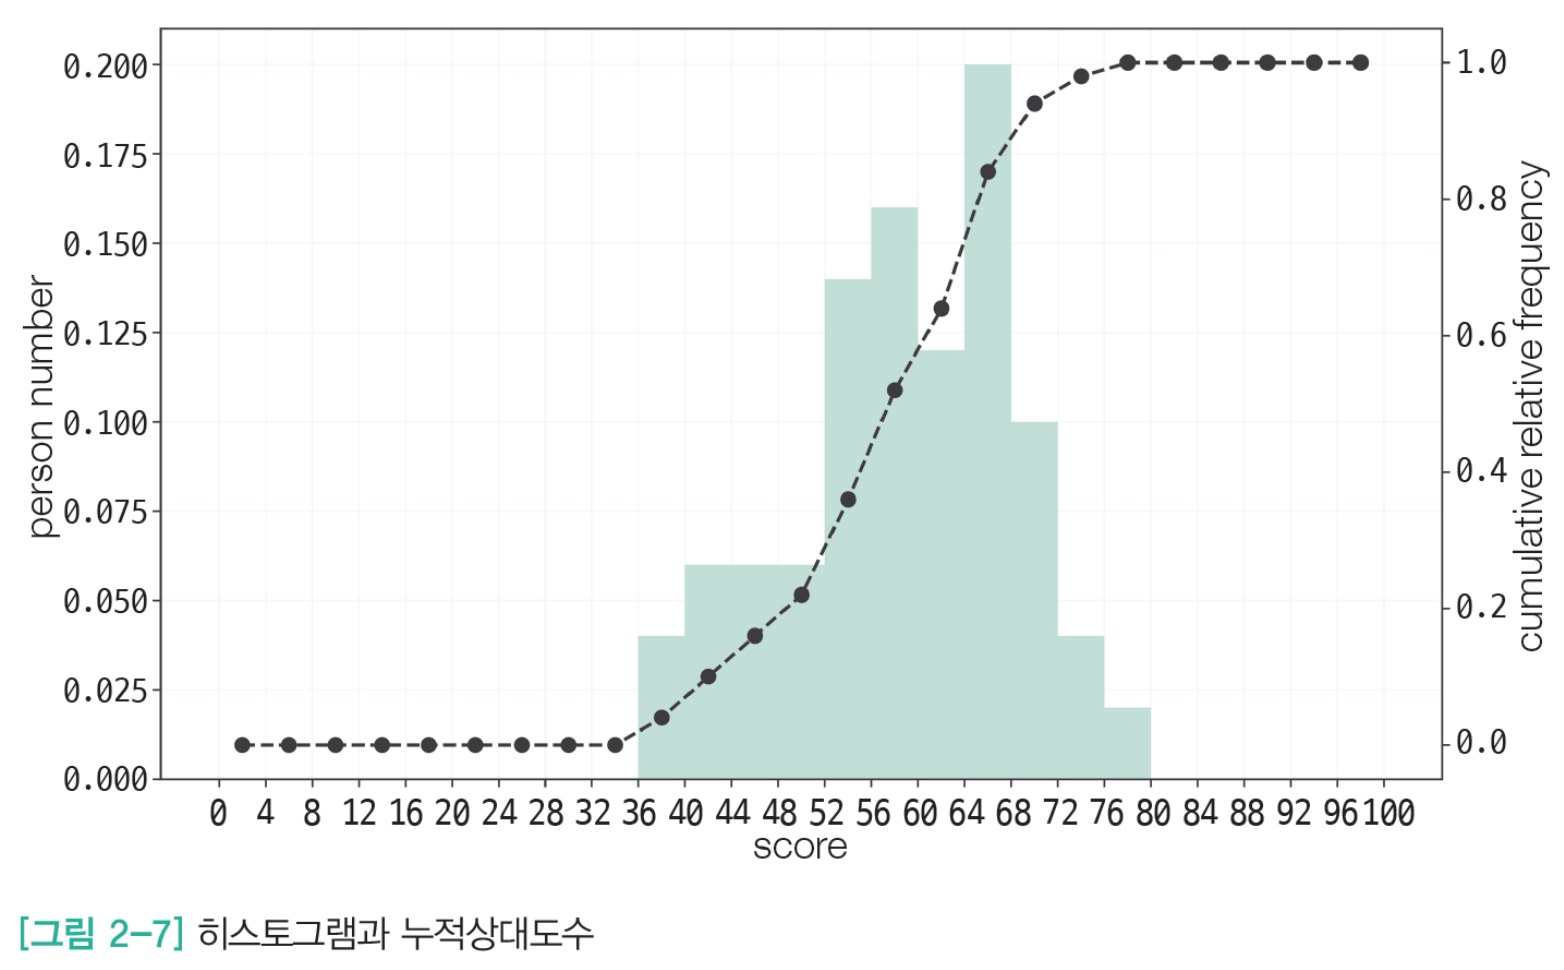
상대도수
- 전체 데이터에 대해서 해당 계급의 데이터가 차지하는 비율
02주차 · 1차원 데이터 정리 — 지표 계산·시각화48
2.4 1차원 데이터의 시각화

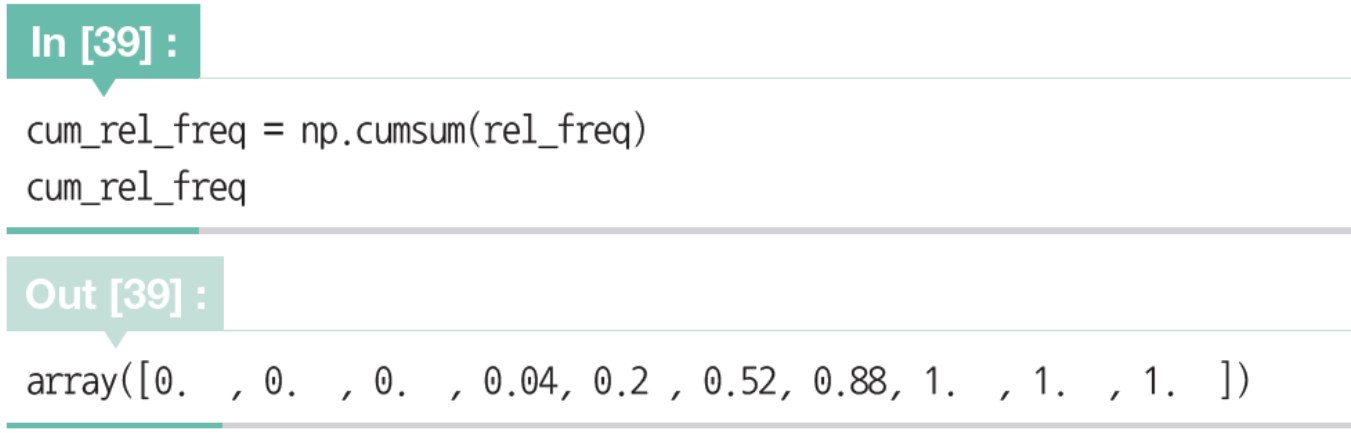
누적상대도수
- 해당 계급까지의 상대도수의 합
02주차 · 1차원 데이터 정리 — 지표 계산·시각화49
2.4 1차원 데이터의 시각화

- 계급값, 상대도수, 누적상대도수를 도수분포표에 추가
02주차 · 1차원 데이터 정리 — 지표 계산·시각화50
2.4 1차원 데이터의 시각화

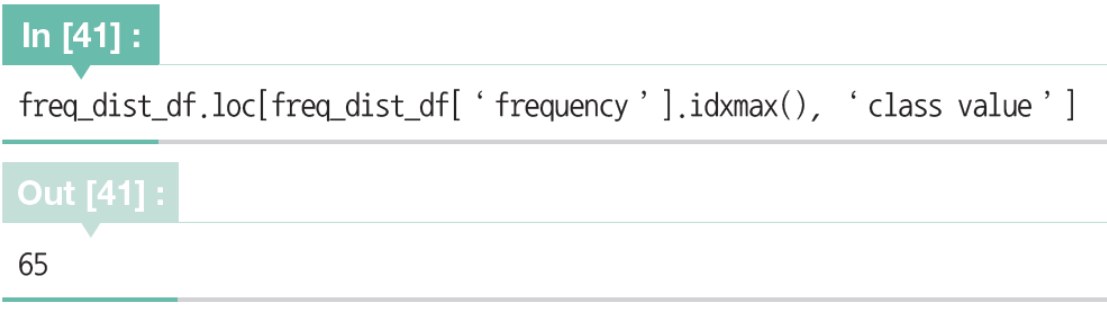
최빈값
- 최대가 되는 계급의 계급값
- 도수분포표를 만드는 방법에 좌우되므로, 계급폭을 4점으로 하면 최빈값은 66점
02주차 · 1차원 데이터 정리 — 지표 계산·시각화51
2.4 1차원 데이터의 시각화

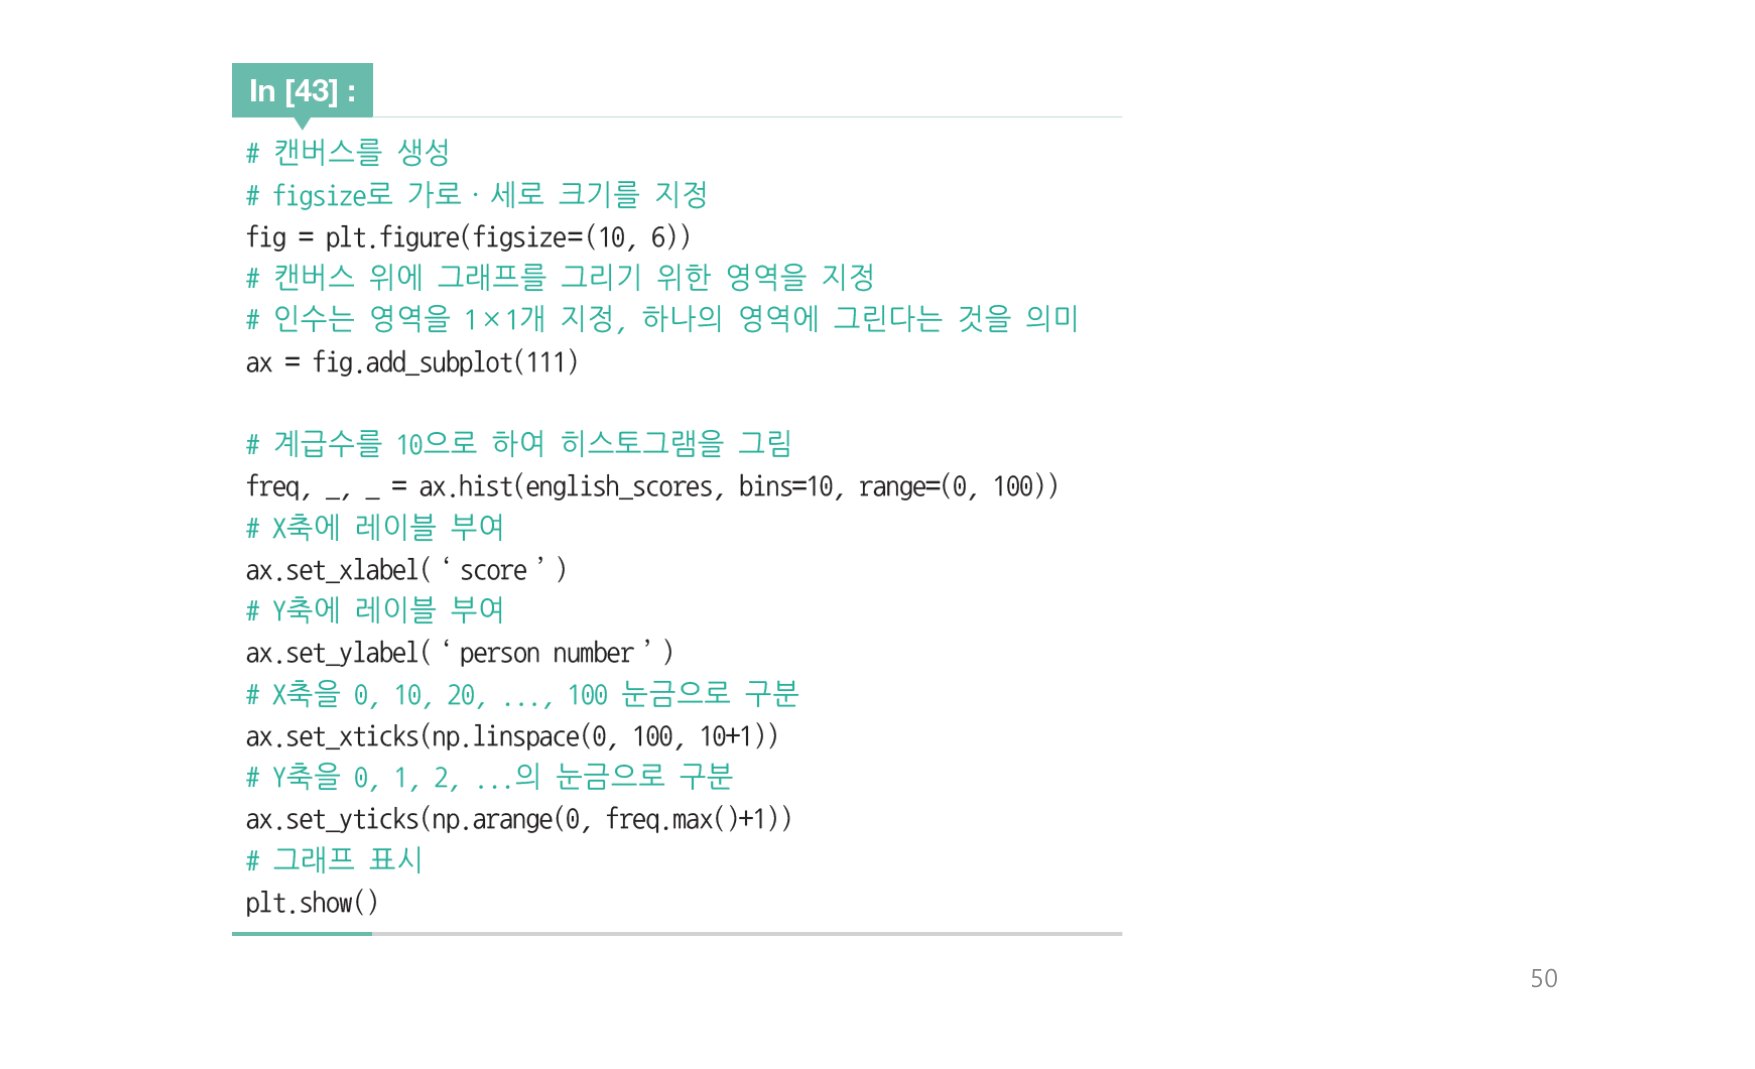
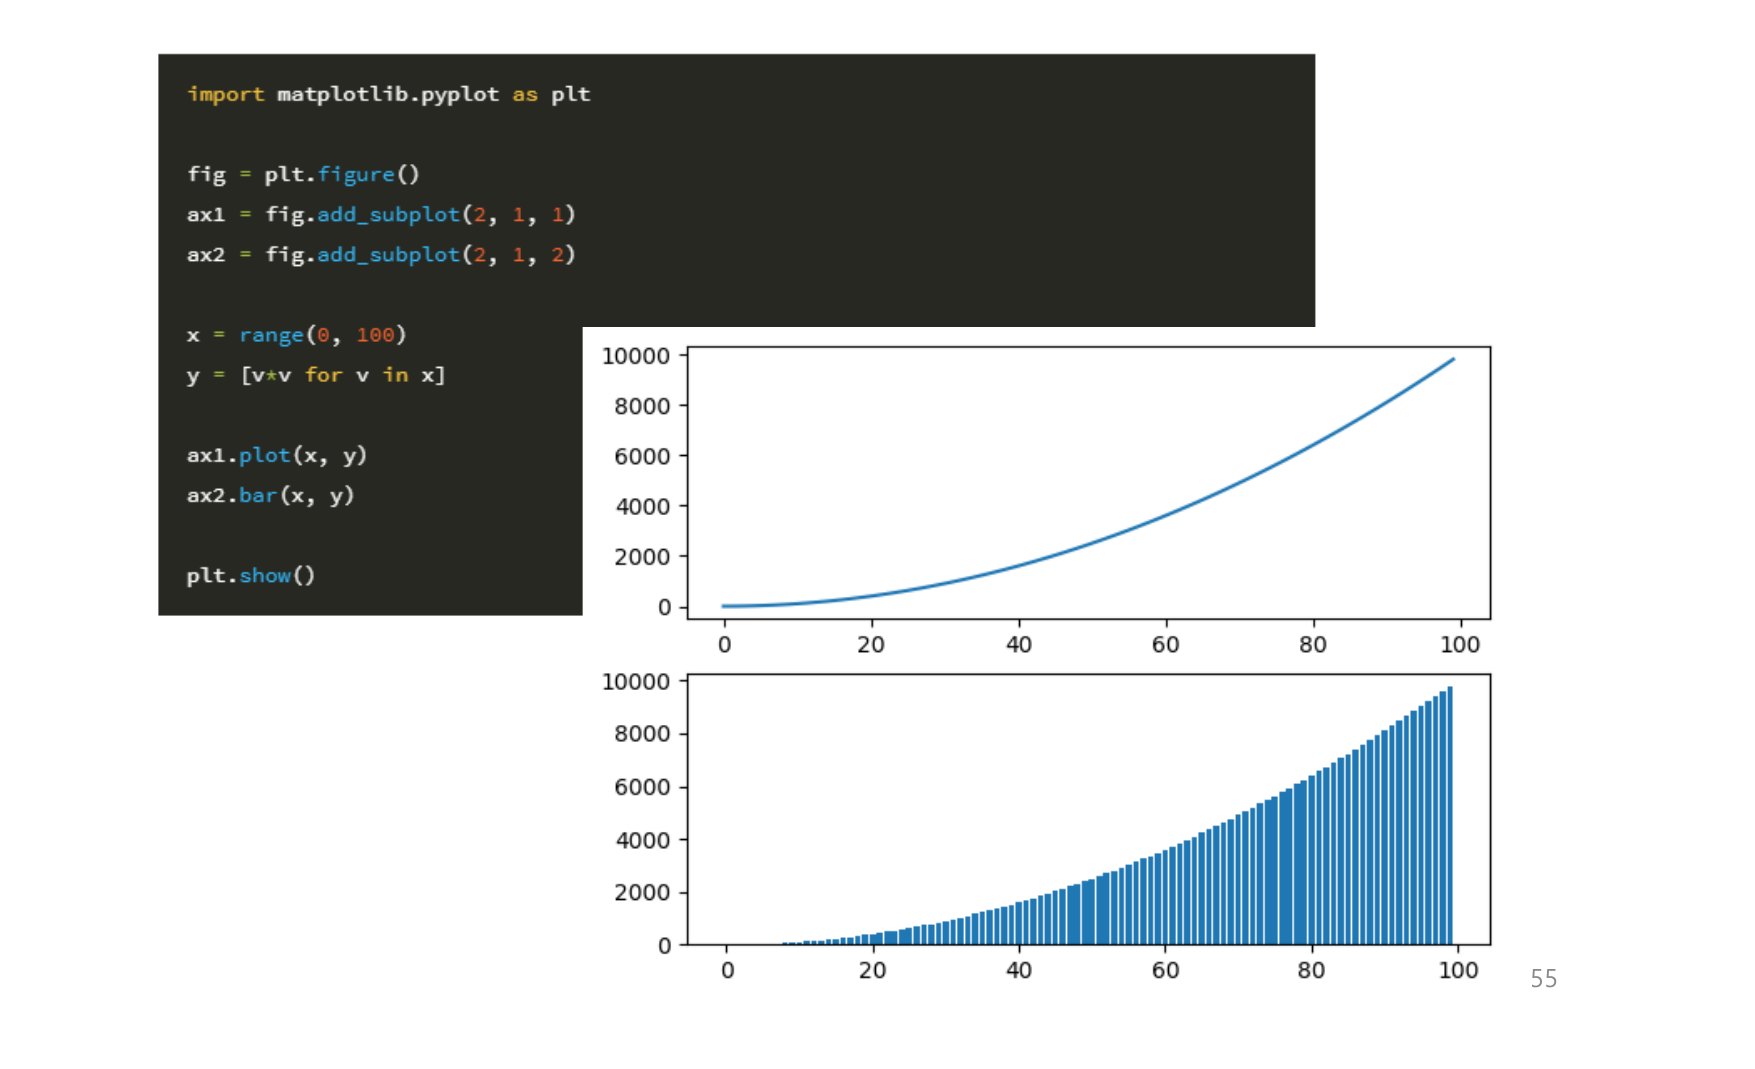
- 도수분포표를 막대그래프로 나타내어 데이터의 분포상태를 더 시각적으로 파악
가능
- 그래프 그리는 데 필요한 Matplotlib 라이브러리 임포트
- 히스토그램은 hist 메서드(NumPy의 histogram 함수와 동일)
02주차 · 1차원 데이터 정리 — 지표 계산·시각화52
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화53
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화54
2.4 1차원 데이터의 시각화

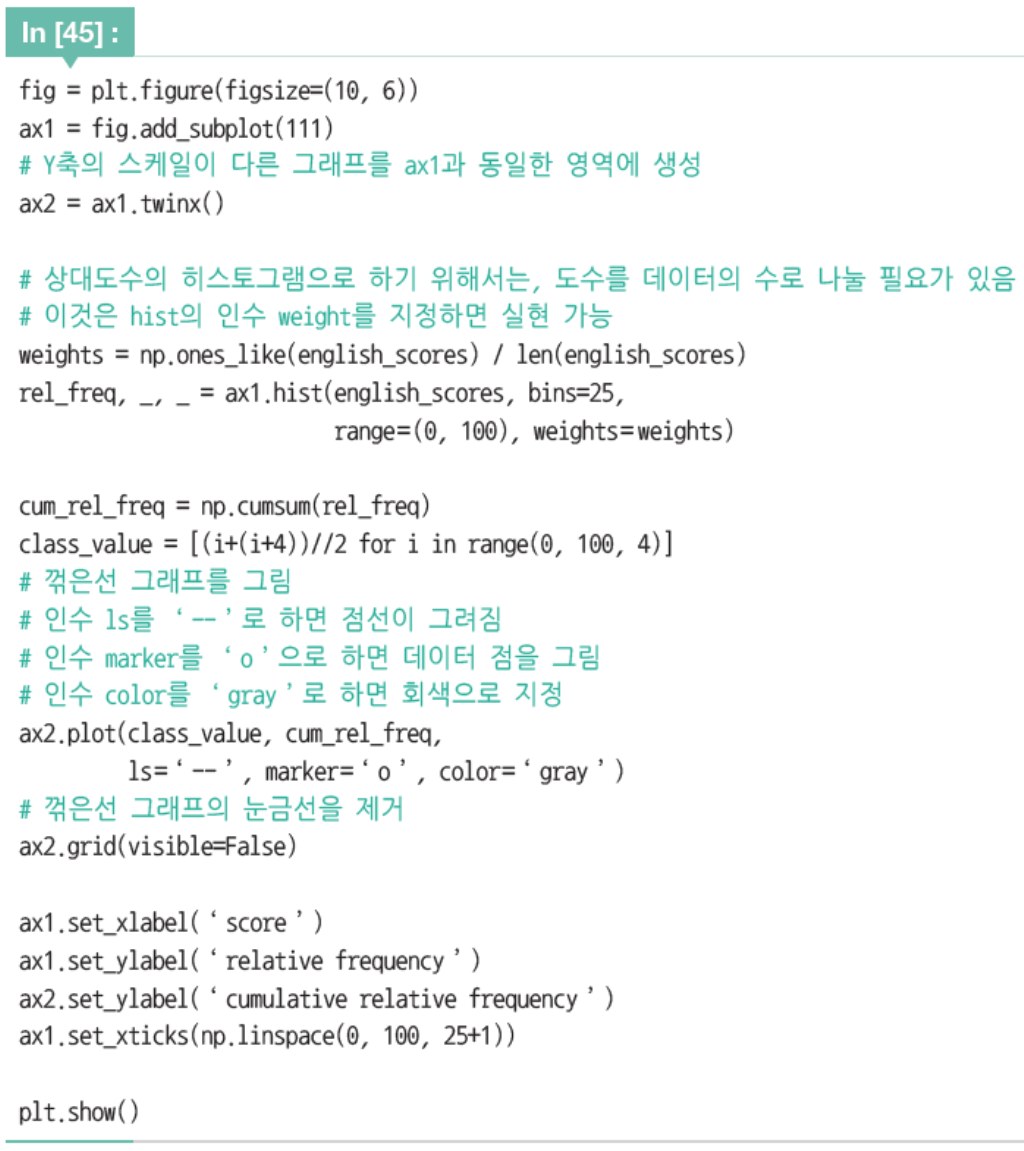
- 계급수를 25, 즉 계급폭을 4점으로 하는 히스토그램을 누적 상대도수의 꺾은선
그래프와 함께 그림
02주차 · 1차원 데이터 정리 — 지표 계산·시각화55
2.4 1차원 데이터의 시각화

- 계급수를 25, 즉 계급폭을 4점으로 하는 히스토그램을 누적 상대도수의
꺾은선 그래프와 함께 그림
02주차 · 1차원 데이터 정리 — 지표 계산·시각화56
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화57
2.4 1차원 데이터의 시각화

02주차 · 1차원 데이터 정리 — 지표 계산·시각화58
시험에 이런 형태로 나올 수 있는 문제입니다. 문제를 띄우면 답 장으로 넘기기 전에 먼저 손으로 풀어 보세요.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화59
02주차 · 1차원 데이터 정리 — 지표 계산·시각화60
3번 — 하루 수면 시간 (연속형)
수면 시간은 7시간과 8시간 사이에 7.5시간, 7.25시간이 얼마든지 있습니다. 나머지는 1.5회, 2.3명처럼 사이 값이 없는 이산형입니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화61
5명의 평균 점수가 70점입니다. 100점을 받은 학생 한 명이 더 들어왔습니다.
5명의 점수를 몰라도 풀 수 있습니다 — 합을 떠올리세요.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화62
합으로 되돌려 다시 나눈다
75점
평균 70점인 5명의 합은 350점입니다. 100점을 더하면 450점이고 6명이므로 450 ÷ 6 = 75점입니다. 한 명의 극단값이 평균을 5점이나 끌어올립니다 — 중앙값을 함께 보는 이유입니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화63
시험이 어려워 모든 학생에게 10점씩 더해 주었습니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화64
2번 — 평균은 10 오르고 분산은 그대로
모두 똑같이 10점씩 올랐으니 서로 떨어진 간격은 변하지 않습니다. 편차 = 값 − 평균에서 값과 평균이 함께 10씩 오르므로 편차가 그대로이고, 분산도 그대로입니다. 반대로 모든 점수를 2배 하면 분산은 4배가 됩니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화65
어떤 반의 점수에서 Q1 = 40점, Q3 = 60점 이었습니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화66
1번 — 가운데 50% 가 40~60점 사이, IQR = 20
Q1 아래에 25%, Q3 위에 25%가 있으므로 그 사이에는 가운데 50%가 들어갑니다. 사분위수만으로는 평균을 알 수 없습니다. 4번은 반대로, 60점 이하는 75%입니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화67
시험 점수의 평균이 70점, 표준편차가 5점입니다. 80점을 받은 학생의 표준화 값 z 와 편차값을 구하세요.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화68
표준화 → 편차값
z = 2, 편차값 = 70
평균보다 표준편차 2개만큼 위이므로 z = 2 입니다. 편차값은 평균 50, 표준편차 10 의 눈금으로 바꾼 것이라 50 + 10 × 2 = 70 입니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화69
20명의 점수를 도수분포표로 정리했습니다. 세 번째 계급(60~80점)의 상대도수와 누적상대도수를 구하세요.
| 계급 | 0~40 | 40~60 | 60~80 | 80~100 |
|---|---|---|---|---|
| 도수 | 2 | 5 | 8 | 5 |
02주차 · 1차원 데이터 정리 — 지표 계산·시각화70
상대도수 0.4, 누적상대도수 0.75
상대도수는 도수 ÷ 전체 = 8 ÷ 20 = 0.4 입니다. 누적상대도수는 그 계급까지 모두 더한 것이라 (2 + 5 + 8) ÷ 20 = 15 ÷ 20 = 0.75 입니다. 마지막 계급의 누적상대도수는 언제나 1 입니다.
02주차 · 1차원 데이터 정리 — 지표 계산·시각화71
Q&A
02주차 · 1차원 데이터 정리 — 지표 계산·시각화72